作成者別アーカイブ: Yu Tamura

不明 のアバター

Yu Tamura について

第二言語習得の研究者。博士(学術)。英語教育のことや統計・データ分析に関わること、趣味のサッカーのことなどについて書いています。

[R] 1列だけの選択ならselect関数よりpull関数を使う

はじめに

dplyr使いの方で,select関数を使って特定の1列に対して何かしらの処理をするということをしたいときにエラーが出る人はpull関数を使いましょうという話です。ちなみに,$使えば問題は解決です。今回は,それ以外の方法で,というお話。

具体的になにをしようとしたか

私がどんな処理をしようとしたかについて少し触れておきます。ここはスキップしてもらっても構いません。

ある列の単語(1単語または2単語の英単語が入っている)の文字数をカウントするということをやろうとしていました。ピリオドが含まれていたり(e.g., “dogs.”),2語の場合は間に空白もあるので(e.g., “beautiful lake”,それらを除去して文字数を数える必要があります。そのためには,str_extract,str_replace, str_lengthなどの文字列処理関数を使う必要があります。しかし,これらの関数はベクトルを受け取って処理をするので,データフレームを渡してもエラーが出てしまうという問題に直面しました。

select関数の挙動

データフレームからある特定の列を引っ張ってくるというとき,もちろん$を使って,dat$wordのようにするのが一番簡単なのでそれでもいいのですけども,dplyr使いの方はselect関数を使っている方も多いのではと思います。ただし,select関数はデータフレームの中から特定の列を引っ張ってくると,それがたとえ1列であってもdata.frame型になります。

よって,処理に使う関数がベクトル型を要求するものだとエラーが発生することになるわけです。しかもやっかいなのは,「じゃあas.vector()関数」を噛ませればいいやんとやってみてもそれでは解決しないからです。理由はよくわかりません。

  dat %>% 
  select(word) %>% #wordという列に文字数カウントしたい文字列があるとする
  as.vector() %>%
  is.vector() #このコードではFALSEとなります

pull関数がすること

pull関数は,要するにdat$x1のように$を使って,またはdat[, x1]のように[,]を使ってデータフレームの中の特定の列を指定するのと同じ挙動をするということです(参考)。よって,pull関数の出力はベクトル型になります。

  dat %>% 
  pull(word) %>%
  is.vector() #このコードではTRUEとなります

というわけで,1列だけ持ってくるときに関数を使う場合はpull()関数を使いましょうというのが結論です。私は結局こういう感じで文字数カウントをしました。

  dat %>% 
  pull(word) %>%
  str_extract(.,"[^\\.]+") %>% #ピリオドを除去
  str_replace(.,pattern = "\\s",replacement = "") %>% #半角スペースを除去
  str_length()->rt_dat$length #文字数をカウント

$を使うと次のようになります。

  str_extract(dat$word,"[^\\.]+") %>% #ピリオドを除去
  str_replace(.,pattern = "\\s",replacement = "") %>% #半角スペースを除去
  str_length()-> dat$length #文字数をカウントしてlengthという列に入れる

$を使ったほうが行数が少なくなるので,そっちのほうがいいような気もしますが,工程の見やすさでいうとpull関数を使うほうが上かなという感じがします。

おわりに

もともと文字数はカウントしてあったのですが,ちょっと査読者の指摘でフィラー項目も入れて分析をやり直さないといけなくなってこういった処理が必要になりました。データ型って基本といえば基本なのですが,以外に気づかずにエラーで困ることもあるので,select関数の挙動について勉強になるいい機会でした。

ということで,pull関数とselect関数,場合によって使い分けましょう。

なにをゆう たむらゆう。

おしまい。

学期はじめのスピーキング・ストラテジー指導

はじめに

私は現在4つ教養外国語の英語科目を担当していますが,そのうちの3つはlistening&speakingのクラスです(うちの大学ではreading&writing, listening&speakingでおおまかに科目が分かれています)。その授業の学期の最初のほうでいつも取り入れているストラテジーの指導があるのでその話です(初級クラスでもできると思いますが中級のほうがしっくりくるとおもいます)。2点あって1点目は「ストラテジー」というよりはset expressionを覚えてしまうという話ですが。

学期が始まる前に書けばもっと参考にしてもらえると思うのですが,学期が終わる頃にこの記事を書くというタイミングの悪さはお許しください。

なぜストラテジー指導?

はじめに,なぜストラテジー指導をしておくかという話です。「英語でやりとりを続けさせるため」というのが大きな理由ですが,もう少し細かくわけていくことができると思います。重複するところもありますが,パッと思いつくのは以下の3つです。

  1. 日本語に逃げ(させ)ないため
  2. 意味交渉の機会をたくさん作り出すため
  3. そもそも会話を継続させるためにどんなことが必要かを知らないため

日本語に逃げさせない

日本語という共通言語が通じる相手に対して英語を使うわけですから,英語でやりとりを続けるのが難しくなったら日本語で言ってしまうことはよくあります。ただ,困ったときにどうしたらいいかを教えておけば,なるべく日本語を使わずに,または日本語は最小限に抑えたまま英語でやりとりを続けることができます。

意味交渉の機会をたくさん作り出すため

これは結構大事にしています。言語習得の(または言語習得にとって有用な事象が起こる)機会をとにかく教室の中でたくさん発生させたいと思って授業をしています。と同時に,困難にぶち当たったときにそこをどう乗り越えるかというのは教室外の言語使用場面でも要求されることが多くあると思いますので,そういったときに立ち向かえること,そしてそういう困難があるかもしれないとわかっていてもトライする勇気を身に着けてもらえることを目指しています。そのためにはある程度ストラテジーの指導が有用だと思っています。

そもそも会話を継続させるためにどんなことが必要かを知らないため

日本語だったらできる(または無意識にやっている)ことでも,英語になったらできなくなってしまうということも結構あると思っています。だからこそ,日本語だったらこういうことやるよね?みたいなことも含めながら,別に英語に限らずコミュニケーションをうまくやるためにはこういうことを意識するといいよなんて話をしています。

具体的に教えること

教室内で使える便利表現のリストをネームカードの後ろにつける

もともとはanf先生がブログにあっぷしていた表現のリストがあって,もう少し長いものだったのですが,そこから厳選したものをネームカードの後ろにつけるようにしています。いつも机の上にネームカードを置かせているので,授業中はそれを「チラ見」することができるというわけです。このネームカードの後ろにset expressionを載せるというのは,名大にいたときの私の副指導教官の先生が実践されていたのを真似しています。

ダウンロードはこちら -> ネームカード

これを授業の最初の帯活動でウォームアップ的にペアで練習してもらうということを最初の数週間はやっています。

この中でも私が特に重視して伝えていることは,相手の言ったことがわからなかったときなどに使える表現です。

What does it mean?

Could you say that again?

わからないことがあったときにわからないことを伝えずにわかったふりをしてしまうことは言語を問わずわりとあったりするものですが,勇気を持ってわからないことはわからないと言おうというように指導しています。これが意味交渉の機会を生み出すからですね。わからないと言われた相手は相手にわかるように発音を工夫したり,または別の言い方に言い換えたりする必要が迫られます。また,わからなかった方はわからなかったことがわかるようになる,理解可能なインプットを得る機会が生まれるからです。

3つのストラテジーを教える

いくつかの便利表現をストックとして持たせたあとは,もう少しスキル的な部分の指導をやります。色々教えるべきことはあると思いますが,私がいつも取り上げているのはecho, reaction, follow-up questionの3つです。

1. echo

相手の言ったことを繰り返す練習をします。実際に学生のうちの一人に簡単な質問をして,

Where are you from?

I’m from Nara.

Oh, you’re from Nara.

のように繰り返す見本をみせます。別に全文を言い換えて繰り返す必要はなく,できたらそれにチャレンジしてみて,難しそうならこの場合なら”Nara”のようにキーワードだけでいいから繰り返すようにしてみようと伝えます。

このechoが大事なのは,次のような点であることも伝えます

  • 相手の言っていることを理解していることを示せる
  • 相手の話に興味を持っていることを示せる
  • 相手の言っていることを聞いていますよということを伝えられる
  • 自分の理解を確かめられる

とくに,最後の自分の理解を確かめるという点を強調していて,繰り返したときにそれが間違っていたら自分が聞き間違えていることになり,それを相手が修正してくれるので会話を進める上では大事だと伝えています。

例:

I’m from Tokyo.

Oh, you’re from Kyoto!

No, no. Tokyo. Not Kyoto.

こういう話をしたあとに,出身,専攻,趣味など,3つくらいの簡単な質問をして,echoを使う練習をします。ここでは,特に会話を広げたりはしなくても良いことにしています。

2. reaction

次がreactionで,相手の答えに対してただechoするだけではなく,なにか一つコメントを入れる練習です。ここでもやりとりの例を見せます。

What are you going to eat for lunch?

I’m going to eat ramen.

Ramen. Sounds nice.

正直このreactionについては,なにか決まったフレーズで覚えておけばいいというものがあるという感じでもないですが,一応次のようなものを例として提示しています。

センゲージラーニングの”Free Talking: Basic Strategies for Building Communication ” (p.25)から持ってきてます。echo, reaction, follow-up questionの3つを取り上げているのはこの教科書を使った2年前より以前からなので,そこはたまたまです。

ここでもまた3つくらい質問を作って,さきほどのようにechoを使ったあとに一言reactionを追加するというようにします。echoもした上でreactionするというのがポイントです。

3. follow-up question

次はfollow-up questionです。相手の答えに対してさらなる追加の質問をするということですね。ここでは以下のような質問とそれに対する回答の例を見せます。

What would you eat for your last supper (dinner)?

I would eat sushi.

この回答に対してどんなfollow-up questionsが考えられるかを学生に少し考えてもらって,いくつか回答を出してもらって黒板に書いていきます。

Where would you like to eat it?

Why would you eat sushi?

What kind of sushi would you eat?

Who would you want to eat with?

How much would you spend on it?

など,WHの疑問文がおそらく出てくることが多いと思いますが,

Did you eat sushi recently?

などのYES/NO疑問文もあり得ることも補足します。

その上で,また新たに3つの質問を学生に与えて,それを質問して,相手に対する回答についてecho, reactionとここまでに練習したものも使った上でさらに今度はfollow-up questionも使ってみようということでトライさせます。

とりあえずfollow-up questionは1つのお題につき1つ尋ねることができればいいことにしています。ここでも,「便利表現」を使う機会があれば積極的に使うように促しています。

もし質問に対して答えるのに困ったらI don’t know…と言ってもいいし,英単語がわからなければ”How do you say 豪邸 in English?”のようにパートナーや教師に聞いてもいいわけです。また,聞き取れなかったら”Could you say that again?”と言ってもいいのです。ただし,学生は「意味が理解できない」とおもったら反射的に”One more”と言い出す事が多いですし,それを乗り越えて”Could you say that again?”が言えたとしてもどんなときでもそれを使ってしまいがちです。そのため,WHの疑問詞を埋め込んだ形で文を作って聞き返すこともこのときに教えます。

つまり,ただたんに聞き取れなかったのではなく,聞き取れはしたけどその一部がわからなかったという場合には,その聞き取れなかった部分だけを相手に言ってもらうほうが,相手も何が伝わらなかったのかがわかるのでコミュニケーション・ブレイクダウンを解消しやすいわけです。

I would want to buy a big house.

と言われたときに”a big house”が聞き取れなかったら,

Sorry, you would want to buy what?

と聞くことで,その部分がわからなかったことを相手に伝えることができます。ただ,これは結構高度な能力が必要で,一回練習しただけで身につくものでもないので,普段の授業の中でも繰り返し意識させるようにしています。

授業の中でも毎回意識させる

私はlistening&speakingの授業では毎回英語でのやりとりが必須となるタスクを用意していますので,そのタスクに取り組ませる際には必ず,

  • set expressionはいつでもチラ見できるようにしておくこと
  • echo, reaction, follow-up questionsを使えるときには積極的に使うこと
  • わからないことがあったときは素直にわからないと伝えること
    • 何がわからなかったのか,できるだけ具体的に伝えること
    • 「わからない」と言われたときはパニックにならず,例を挙げる,別の表現で言い換えるなどで伝えてみること
    • 英語でなんて言ったらいいかわからなかったら積極的に手をあげて教師を呼ぶこと

も伝えています。

こういうのも,学期を通して,または年間を通して最終的に身に着けてくれていたらいいと思っていることなので,とくにこれらができていないことで毎回のタスクの評価にいれるとかはしていません(そもそもそういうプロセスの評価は毎回はできないですしね)。

机間巡視しながら,「もっかい言って?」なんていうのが聞こえたら,”You can say ‘could you say that again?'”なんてフィードバックをしたりしていますし,自分の言っていることがなかなか相手に伝わっていなくても諦めずにトライしている学生のことはできるかぎりencourageしてあげて,必要なら私が言葉を補ってあげることもあります。

タスク後は言いたかったけど言えなかったことの指導にあてることが多いですが,気づいたらうまい言い換えをしていた例(e.g., disagreeやbe againstのような表現が出てこず,say noのように言っていたとか)をとりあげたり,相手の意見を自分の言葉で言い換えていた例(e.g., I think that he should…をSo, you think it is better for him to do…のように言ってたりとか)をとりあげたりすることを意識しています。

特に,相手の言っていることを自分が理解できているかを確認する意味でも,ただOKOKとかechoだけにとどまらない形でcomprehension checkを行えるのはとても大事なので,こういうのは積極的にやっていこうねというのは言うようにしています。これもストラテジー指導の一環としてとりあげて教えてもいいかもしれないのですが,実は意味順もちょっとやってるので90分でなかなか収まらないんですよね。結果として,授業の中で取り上げて指導するという形に今はなっています。

おわりに

本記事では,やりとりを要求するタスクに取り組ませる前の段階としてどういうことを指導しているかということを書きました。こうやって記事にしてまとめてみるとちょっと不十分というか穴があるかなと感じるところもあったので,そこは来年度以降もう少し工夫してやっていこうかなと思います。

なにをゆう たむらゆう。

おしまい。
今の仕事をしていなかったら何をしますか?今の仕事の魅力は何ですか?

割と長く文章書けそうな質問をQuerie.meでもらったのでブログ記事書いちゃいます。

タイトルの通り,

今の仕事をしていなかったら何をしますか?今の仕事の魅力は何ですか?

というもの。一つずつ答えていきます。

今の仕事をしていなかったら?

まず,そもそも私は小学生の時から学校教員志望でした。24歳で教員採用試験を受ける時まで,本気で学校英語教員になろうと思っていました。それが,まあ教員採用試験に落ちたので,研究の道に進んだのです。私の分野では博士号取得後は大学教員のポストに就くというのが王道ルートというか,それ以外の選択肢はほとんどないので大学教員の就職を目指して,関西大学外国語学部に着任することになりました。

大学教員に実際になってみて思うのは,まあ世の中には他にも色々な仕事があるだろうけれども,今の待遇で自分の能力が発揮できそうな仕事で,ワーク・ライフ・バランスもある,そういう仕事ってなかなかないだろうなと思います。そう考えると,今の仕事してなかったら死んでるかもしれないですね。

もしも,一日中ひたすらRでデータ処理とかデータ分析とかしていれば良い裁量労働制の仕事で今と同じ給料もらえるのなら転職してもいいです。

今の仕事の魅力はなんですか?

仕事というと「大学教員」というカテゴリになるかと思いますが,正直言って大学ごとに環境は全然違いますし,もっといえば同じ大学でも学部が違えば風土も全然違います。よって,仕事の魅力を語ろうと思うと今の職場の魅力を語ることに必然的になってしまいますね。

待遇とワーク・ライフ・バランス

そういうことを断った上で魅力を考えてみます。まずは上にも書きましたが,待遇が良いのとワーク・ライフ・バランスがあるというのは魅力だと思います。就職したのが30歳で貯金も微々たるもの&数百万の借金抱えてるところからスタートなので,それなりに待遇良くないとやっていけないというのはありますが,それでも全国に数ある大学の中で待遇はいいほうだと思います。それは魅力的ですね。待遇がいいと労働時間が長いというのもセットでついてきそうですが,裁量労働制なのでそこは自分次第でコントロールできます。勤務時間に自由が効くというのは非常に魅力的ですよね。水曜日や金曜日にサッカーの試合を見に行ける,これは誰もが得られる環境ではないと思います。

人間関係

私が自分の中で仕事に関して一つの軸として持っていることがあって,どっかで誰かが言ってた話(たぶん津田大介さんがどこかで話してた)なんですが,仕事を続けるか辞めるかの選択をするときには次の3つのうち2つが満たされていれば続ける,1つしか満たされていないなら辞める,というものです。

  1. お金
  2. 人間関係
  3. 自分のやりたいことができる

上述のように,お金はクリアしています。では2番目の人間関係はどうかというと,これも非常に恵まれていると断言していいです。就職して5年目ですが,同僚の先生には感謝してもしきれないですね。特に,この人のためなら頑張りたいと思える人たちがたくさんいること,悩みを相談できる人たちがいること,は本当に大きいです。

色々ストレスが溜まる仕事はやってきますが,それは別に人間関係が悪いから発生する仕事では全くありません。むしろ人間関係が良いからこそストレスが溜まる仕事も乗り越えられると思っています。ただ,私はあんまりコミュニケーションを積極的に取りに行くタイプでもないので,お昼ごはんを一緒に食べに行くとか,帰り道一緒に帰るとかはほとんどありません。学内で会ってもそんなに長く立ち話をしたりもしないし,「あ,こんにちは」とか「お疲れ様です」だけのこともよくあります。でもそれは同僚の先生が好きじゃないとか大切に思っていないとかそういうことではなく,そういうのがすこぶる苦手というだけです。

2018, 2019年度は毎学期終わりにお疲れ会みたいな飲み会をしていましたが,2020年度になってそういう大人数で集まる機会はなくなってしまったのが残念です。最近は少人数での飲み会はしていて,そうやって誘われて飲みに行っていろいろな話をできるのは恵まれているなと思います。特に,私は大阪に昔からの友人がいないので,職場の人達との人間関係が悪かったら本当に人付き合いゼロですからね。別に一人でいるのは好きだから楽でいいんですけど。

ちなみに,事務の方々もみなさん良い方ばかりで,気持ちよく仕事をできています。そういうところの「同僚」というか「人間関係」もいいですね。

自分のやりたいことができる

これは,まあ満たされていると言っていいのかなと思います。もちろん,専門科目を持ちたいけどこれまで持たせてもらっていないことは,自分がやりたいことができていないということではあります。ただ,一生そうじゃないのがわかっていて,いずれそういう科目を担当することになるという道筋が見えていることでそこまで不満を持つことにはなりません。

英語を教えることだってそれなりに好きなことだからこういう仕事をやっているわけですしね。自分が担当したくない授業をやらされたり,研究の時間も取れないほどのコマ数を担当させられることもありません。

学内業務についても,ある程度仕事を任せてもらえること,自分の意見を反映させる機会が確保されていることは,働く上でとても大事なことだと思います。全部指示されるまま,思っていることは言えない,というわけではなく,年齢とかキャリアに関係なく思ったことは会議で発言できますし,疑問に思ったことはすぐに聞けるという環境です。

もっとトップダウンな大学の話とかを聞いたことがあるので,大学教員一人ひとりの意見を尊重する職場の雰囲気は居心地がいいです。ただ,それが故に会議が長くなることがしばしば発生するんですが。とはいえ,会議は短いほうがいいというコンセンサスを持っている人はいますので,サクサク会議を進めようとしてもらえるのはありがたいです。そういう人たちのおかげで私は教授会のあとにサッカーを見に行くことができます。まあ,私は幸い夜までかかる会議にはまだ参加していないので不満に思っていないだけかもしれませんけど。

研究支援も手厚く(自分は感じています),個人研究費も使いやすく額もそれなりにありますし,科研費に応募しようと思えば特に若手教員は添削サービスや講習会みたいなものを無料で受けられますし,むしろ大学的にも科研費獲得を支援するサービスを教員に積極的に使ってもらうことを推奨しています。私も今もらっている科研費を取るまでは随分サポートしていただきました。また,学内研究費もいくつかあって,2年目に若手研究者育成経費というのに応募して採用されました。最初の年にスタートアップ支援に通らず,次の年の若手研究も落ちた私としては学内研究費で研究資金を得ることができたのは非常に助かりました。

実験をメインにやる私としては謝金の支払いがめんどくさいことだけが唯一改善してもらいたいなと思うところで,いつもストレスが溜まりますが,まあそれくらいですよね。できるだけ大学教員側の手間がかからないような仕組みづくりをしようというのは私が着任して以降も見られてますので,仕事をしやすくしよう,という風土があるのは感じられます。

個室が与えられる

最後にこれ。個人研究室というものがあって,そこが仕事場です。つまり,自分ひとりだけの空間があって,そこで自分のしたいように仕事ができる。これは超絶魅力的だと思います。普通の職場ではかなりの役職にならないと個室が与えられることってないんじゃないでしょうか。私の部屋がどんな感じかは私のウェブサイトのトップページに写真があるので御覧ください。

私は多分大学教員の中でもかなり自分の研究室が好きな方で,一日のほとんどの時間をそこで過ごしていて,家は帰って寝るだけという日が多いです。長いときだと7時-23時とかで職場にいることもあります。でも別にそのうちの2時間を昼寝とかしてたっていいわけですしね。個室があるからこそ研究室で筋トレができますし,冷蔵庫も電子レンジも置いているので食事も容易にとれますし,なんでもできます。シャワールームがついてたらと思ったことあるのは私だけではないでしょう(笑)

誰にも邪魔されない自分だけの,自分が一番快適に過ごせる空間がある。しかもそこをいつでも使える(別に終電なくなろうが徹夜しようが誰かになにか迷惑をかけたりはしない)というのは今の仕事の大きな魅力の一つでしょうし,それに憧れるという人も結構いるんじゃないでしょうか。

おわりに

というわけで,Querie.meで質問されたので,ブログ記事にしちゃいました。私に質問されたい方は質問お待ちしています。

https://querie.me/user/tam07pb915

なにをゆう たむらゆう。

おしまい。

「英語を使う必然性」の呪縛

Photo by Max Fischer on Pexels.com

はじめに

もうかれこれ2ヶ月前くらいですが,大阪府の英語コーディネーター連絡会というものでお話する機会をいただきました。その準備をしながら,また関係者の方々とお話をさせていただく中で思ったことをブログ記事にまとめようとして,下書き状態のままずるずるとここまで来てしまいました。

実は学会のようなイベント以外でお話するというのは今回が初めての経験でした。学校英語教員を目指していた私が偉そうにこういうところに呼ばれてお話するようになったのかと思うと,権威性が自分の意図とは関係なくまとわりついてしまうものなのだなとも思いました。そこに自覚的でなくてはいけないなと。

そのお話の中では,タスクの定義というレンズを通して様々な活動を見てみることで,その活動に何が足りないのか,どういう目的でその活動が行われるのかといったメタ的な視点が手に入り,それが授業内の活動を設計するために有用ではないかという話をしました。関連して,真正性(authenticity)という概念をとりあげ,コミュニケーション場面の具体性(その場面を学習者が将来的に経験する可能性があるかどうか)を過度に重視する必要もあまりないということも述べました。

打ち合わせをする中で,「英語を使う必然性」というものが強く求められているような状況があり,そこに苦労されている先生が多いということも伺いました。私の答えは以下に述べるとおり,コミュニケーションの必然性,は大事であっても「英語を使う」必然性に拘る必要はないかなというものです。

英語を使う必然性とはなにか

英語を使う必然性というのは,「なぜ英語でそれをやるのか」ということであるのでしょう。連絡会前の打ち合わせでも「それって英語でやる必要ないよね?日本語でもよくない?」というようなことが話題にあがるという話を聞きました。そもそも,日本のような外国語として英語を学ぶ環境では,「英語を使う必然性」というのは教室外ではないに等しく,教室の中で英語を使う必然性というのは,「英語の授業だから英語を使う」以外に設定できないと思います。そもそも,日本語話者同士で英語でやりとりするわけですので。

必然性の重視は実用性論争にもつながる

それって英語でやる必要ある?は悪手

この問自体が少なくとも日本の学校教育における英語教育ではあまりいい問ではないと思います。英語教育の存在自体を自明視するという文脈であればまた別の議論になると思いますが,教室内の活動の質を高めようという営みにおいては大事なことはそこではないというのが私の考えです。

必然性が実用性につながってしまう

学校教育に対して実用性を求めるような人たち(最近で言えば三角関数の話)への反論で,実社会における実用性の過度な重視に反論するような人たち)でも,英語教育においては実用性を求めているのではというようなケースも見られる気がしています。最近(と言っても書いたのはこの記事を公開するよりもだいぶ前なんですけど)英語教育で道案内とかやるよりはウェブ上で(例えばYouTubeで)自分の手に入れたい情報にたどり着けるかどうかとかそういうほうが実用性高いと思う,というようなTweetが私のタイムラインに流れてきたりもしました。その比較でいえばそうかもしれませんが,だから授業でそれをやればよいかというと,そういうわけにもいかないと思います。

学校教育の内容が実用性という観点のみにおいて構成されることは結構危ういと思うからです。誰がその実用性を決めるのかという問題がありますし,その実用性が学校教育を受ける世代が「社会」に飛び出したときに実用性があるかもわからないからです。教育がもたらす恩恵というのは,変化の激しい社会においても揺らぎができる限り少ないものを対象にすべきであるのではないかと思いますし,変化が激しいからといってそれに合わせて頻繁にコロコロと内容が変わるべきものでもないような気がします。そう考えれば,今の世の中で必要になっているものがこの先も同じ程度に必要であるとは限りませんし,未来にどんなものが必要になるかを私達は予想することはできません。

その観点で言えば,道案内もYouTubeの動画検索も学校教育における英語教育の目標として適切であるというようには私は思いません。私たちが現実にその具体的行動を英語を用いて行うことがあり得るか,そしてそれができるように学校教育における英語授業の活動が構成されるべきか,とは思わないということです。むしろ,一見するとそんなことは私たちの実生活では起こりようがない,というような活動の背後にある,あるいはそこで発生する言語使用を抽象的なレベルで観察したときに,そこに私たちが日常的に行う言語行為に近似したものが含まれているのかどうか,ということを考えるほうが有用だと思うのです。

真正性(authenticity)という考え方

2つの真正性: 状況的真正性(situational authenticity)とやりとりの真正性(interactional authenticity)

やりとりの真正性とは,その行為自体が現実には起こり得ないとしても,そこで発生する情報のやりとりであったり,言語を使用する際に頭の中で起こることが,現実場面のものと同じ(または限りなく近い)ということを意味します。Michael Longは前者を重視する立場で,Rod Ellisは後者の役割も認める立場で,私個人的にも後者の立場です。なぜなら,言語学習の明確な目的を設定できるような場合以外ではsituational authenticityを重視したタスクを中心に授業を計画することの妥当性が疑われるからです。

状況的真正性を過度に重視することの妥当性

なんらかの職業訓練の一環としての言語教育などは,言語の使用場面が非常に限定的であり,学習者が身につけるべき言語能力も基本的にはそうした場面で適切に言語を使用して業務を遂行できるためのものになります。しかしながら,日本のような英語を外国語として学ぶ環境で,なおかつ学校教育において行われる英語教育では学習者全員が身につけるべき具体的な場面における言語使用を定義することがほぼ不可能であるといえます。したがって,そうした場面を考えるよりもむしろ一段階抽象度をあげて,描写する,比較する,説得する,説明する,順位付けをする,取捨選択をする,などの行為が含まれるようなタスクを考えるほうが現実的でしょう。

「必然性」を活かす手はある

ここまで,英語を使う必然性というのはあまり有用ではないというスタンスで述べてきましたが,私が批判的に考察したのは必然性に縛られすぎることで,その英語を使う必然性というのを活かすことはありえると思います。その一つがALTの活用です(人という存在に対して活用というのはあまり良くないかもしれないですが他に表現が思い浮かびませんでした)。ALTは多くの学習者たちにとっておそらく唯一コミュニケーションの際に英語を使う必然性の生まれる存在だと思います。その特性を生かして,ALT相手に何かをプレゼンさせたり質問させたりするような仕組みを作っている方も多くいらっしゃると思います。仮にALTは日本語であったり,あるいは日本語話者が犯しがちな誤りが発話に含まれていても理解できたとしても,”What do you mean?” “What does X mean?”などと聞き返してもらうようにすることも不自然ではありませんから,そこにnegotiation for meaningも生まれるでしょう。下記のanf先生の記事で紹介されているのはそうした活動かと思います。

目的・場面・状況

少し関連するかもしれないのが,学習指導要領のキーワードにもなっている「目的・場面・状況」というワードです。外国語科の目標に入っている文言ですね。個人的には,「目的・場面・状況」というのがセットになっていると活動の構想が難しく,あえてそれらの文言を使うとすればまずは目的を先に設定し,そのあとに場面と状況を考える,というようにすることが多いです。具体的には次のような手順で活動を構想するのがやりやすいと思っています。

  1. タスクタイプ(e.g., 情報伝達,情報合成,問題解決,意思決定,意見交換)を決める
  2. タスクの目的(goal)を決める(e.g., 順位付けする,選択肢の中から選ぶ,アイデアを生み出す)
  3. 場面と状況を決める
  4. 実施形態を決める

1と2は一緒に考えることになる,または2が先に来ることもありうるかと思いますが,私はまず最初に,「教科書の今回のユニットの内容は意思決定タスクでやろう」のように決め打ちしてまうことが多いです。そうすると,必然的に考えなくてはいけないことが狭まるからです。そのタスクで求められることに合わせて場面を構成していくほうが,それらを全部合わせて考えるよりも楽だと思っています。意思決定タスクに決めたら,次はどのような意思決定をさせるのかを考えます。年老いた父親の介護という問題に直面している夫婦の話(私が担当している授業の一つで使っているImpact Issues2のUnit 9にでてきます)であれば,この夫婦に対して何かアドバイスを考えてメールを書く,ということをタスクのゴールに設定したとしましょう。そこが決まったら,場面と状況を考えます。夫婦たちとの関係性はどうなのか(友人,親族,隣人,etc.)とか,教科書には描かれていない夫婦の背景的なところ(e.g., 親との関係性,夫婦の家族の状況,etc.)とかを考えるわけです。仮にその年老いた父親が自分の父親でもあるという設定(これでも自分が長女・長男なのかどうかで随分話は変わりますけど)であれば,親の介護の問題は他人事ではなく自分ごとになります。一方で,いくら仲良しでも友人としてアドバイスを,ということなら,家族の問題は非常にセンシティブな問題ですから,そこに対してのアドバイスは相手から求められていてもかなり慎重さが求められるはずです。

しかし,そのような場面や状況の設定は,あくまで最終的なゴールである「アドバイスをする」という部分を変えるわけではありません。あくまで,どのような内容を伝えるか,それをどのように伝えるか,に変化を与えるいわば「設定」の部分なわけです。前述のように,そしてまた以下のスレッドで亘理先生が指摘しているように,そこが曖昧であればタスクに取り組みにくくなるのは当然です。

設定の部分をタスクに実際に取り組む学習者の想像に委ねてしまうことになるわけで,まずはその想像しないといけない部分をペアやグループですり合わせる作業が必要になるからです。もちろん,そこをプレタスクとしてしまうのも一つの手ではあると思いますが。例えば,うちのペアはこういう関係性の友人としてのアドバイスです,とか,うちのペアは自分が怠け者長男で,妹が介護を引き受けようとしているという設定にしました,とか。そのうえでタスクに取り組ませれば,友人なのでこういうところに気をつけました,とか,怠け者の長男にもこれこれこういう事情があって….というように様々な場面や状況で学習者は言語を使うことになるでしょう。そして,そのバリエーションの差によって生まれる言語使用の差を取り上げて形式面に着目させるのも一つの授業でしょう。

少し脱線しましたが,場面と状況が決まったら実施形態を決めます。ペアでやるのか,グループでやるのかというのもそうですし,準備は何をどのようにどれくらいの時間をかけてやらせるのか,タスク後にはどんなことをさせるのか,というようなことを考えるわけです。タスクを考える,そしてゴールを決める,そのあとに場面と状況を決めるというのが私がいつも授業を考える道筋です。タスクを考えるほうが楽,というのはもちろん私のドメイン知識に依存する部分も大きいとは思いますが,本当にそう思っています。そして,「思考・判断・表現」をどうするかということを考える上では,タスク(タイプ)を考えることから始めるというのは一つのストラテジーでありなんじゃないかな,ということですね。下記のツイートで言いたかったのはそういうことでした。

おわりに

なんだかタイトルからだいぶ脱線してしまいました。記事を書き始めたときから2ヶ月近く経ってしまったからですね。ただ,後半部分の話は先日の学会のときのTwitterでのやりとりをきっかけに考えたことでもあるので,学会をきっかけに思考が刺激されるという体験は結構久しぶりだったな,なんて思ってしまいました。良くないですね。このブログの記事の更新スピードも下がっていますが,まだいくつか下書き状態の記事があるので,また時間をみつけて記事を更新していきたいと思います。

なにをゆう たむらゆう。

おしまい。

[R] Collaborative Writing準備時短テク

はじめに

以前,下記のようなブログ記事を書きました。

一言で言えば,教師側で作ったテンプレファイルをフォルダごと学生と共有し,学生は自分の名前のついているWordファイル上で執筆活動を行い,教師側はリアルタイムでその進捗をモニタしつつフィードバックを出していくというようなライティング授業実践です。

今年度からは3年次のライティング授業も持っていて,その授業ではペアでのcollaborative writingも取り入れています。最初はペアはこちらで作ってファイルは学生に作らせてリンクを教師と共有という形でやっていましたが,それだとやっぱり使い勝手が悪い(教師側が自分のローカルからファイル閲覧できないとか他にも色々問題ががが)というのがあって,やっぱり教師が学生のファイルを作るほうがいいだろうという結論に至りました。

超えるべきハードル

1. 学生のペアリング

これは昔知り合いの川口先生がブログ記事に書いていたような気がするなと調べたらすぐ見つかったので,そこの記事で紹介されているものをそのまま使いました。

2. ペアリングした文字列をファイル名に転用できるようにする

上記ブログ記事先のやり方でやると,リスト形式で学生のペアリングリストが手に入ります。ただし,それをファイル名に転用できるようにしようとするとひと手間工夫が必要です。リストのそれぞれの要素に入っているクォーテーションマークでくくられた名前を結合して1つにまとめる必要があるからです。

私がもともとやっていたのは,文字列ベクトルの1つ目から順番にとってきて,それをファイル名にするというものでした。今回はペアですので2人(もし奇数なら3人組もできる)の名前を1つのファイル名にしようということになります。

リスト内の要素を結合するには次のようにします。

sapply(pairing,paste,collapse="&")->pairing2

pairingがリスト形式のグループ分けです。最終的にpairing2という変数には

"TAMURA Yu&KAWAGUCHI Yusaku" "TERAI Masato&FUKUTA Junya"

といったように名前が&でつながれた文字列のベクトルが入っています。あとはテンプレファイル複製のやり方と同じです。

setwd(here("Week9&10"));getwd() #Create a folder before runnning this code
dirnow <-getwd()
list1<-list.files()
print(list1)
original<-file.path(dirnow,list1) #Use the original file name
filename1<-paste(pairing2,list1,sep="_")
print(filename1) #Check all the file names
for (i in 1:length(filename1)){
file.copy(from=original,to=paste(dirnow,filename1[i],sep="/"))
}
list.files()

私は”rename”というフォルダ内にその週の課題ファイルを入れるフォルダを作っています。そのrenameという場所にRStudioがあるので,そこがワーキングディレクトリとなっています。それをその1つ下の階層に移してあげるのが1行目です。”Week9&10″というのがフォルダ名ということですね。そこに, “2022_Spring_AW_Week9&10.docx”という名前のテンプレファイルが1つはいっています。

3,4行目はそのコピー元ファイルがちゃんとあることの確認ですね。6行目でペアリングされた学生の名前が&で結ばれたものと,テンプレファイル名をアンダーバーでくっつけています。こうすることで,filename1という変数内には,

"TAMURA Yu&KAWAGUCHI Yusaku_2022_Spring_AW_Week9&10.docx" "TERAI Masato&FUKUTA Junya_2022_Spring_AW_Week9&10.docx"

のような最終的に変換されるファイル名が入ります。あとはfor関数の中でfile.copy関数を使ってファイルを複製し,そのときのファイル名をさきほど作ったfilename1の1番から最後までにしてあげるということになっています。

最後に元のテンプレファイルをフォルダから削除し,renameフォルダ内から”Week9&10″をひとつ上の階層(私の場合授業のフォルダ)にあげてからフォルダごと共有リンクをLMSに貼ればOKです。学生側はフォルダにアクセスし,自分の名前が入ったファイル上でペアと一緒にライティングをしていくことになります。

補足

もしも,ペアリングは自動ではなく手動でやりたいという場合は,エクセルなんかで2列になったものをコピーして,pairing変数にいれてあげればあとは同じようにできると思います。

おわりに

このRのルーティンを作るのに調べ物とかも含めて1時間くらいかかりました。そこで気づいたのですが,自分の担当しているのクラスは12人という少クラスで6ペアしかできないので,こんなことしなくても手作業複製とファイル名変更したほうが作業効率がよかったのではないか…という。

もっと大人数のクラスでcollaborative writingをやろうと思っていて,でもファイル管理がめんどくさい…という方の助けになれば。

なにをゆう たむらゆう。

おしまい。

「業績的価値」が低く見積もられる論文を書く意味

はじめに

水曜の会議で,研究科の紀要への投稿が少ないみたいな話題が出ていました。私は(研究科の担当をしていないため)厳密には研究科委員会の構成員ではないのですが,慣例で学部教授会構成員は出るような感じなので大学院はこういう感じなのだなぁといつも思いながら話を聞いています。この話題に関しては思うところがちょっとあったので,Twitterに書いたことも含めて再構成してまとめておこうと思います。ちなみに,分野横断的に通じる話ではないと思いますので,私が所属しているのは外国語学部(そしてその上にあるのは外国語教育学研究科)であるということを念頭に以下をお読みください。

「業績的価値」

一応カッコ書きにしました。研究の価値を決めるための代理指標としては一定程度論文が掲載される媒体というのが機能している部分は否めないと思います。そして,そのことを研究者(または研究組織)の業績評価に使用している部分もあると思います。査読システム自体を全否定するほどラディカルな意見は私は持っていません。ただし,現状の査読システムは問題も多いとは思っています。今回はその話はしません。あくまで現状として,査読があるかないか,紀要であれば地方レベルか全国レベルか,国内誌か国際誌か,国際誌でいえばSJRはどれくらいかというような,それなりに研究者が持っていそうな(あるいは表立ってはいないけれども組織内で数値的に優劣がつけられていそうな)「業績的価値」が低いと考えられているような媒体へ投稿することにはどんな意味があるだろうか,そこに院生が投稿しようと思えるにはどうしたらいいのか,そういうことを書きます。

そもそも研究科の紀要とはどういったものか

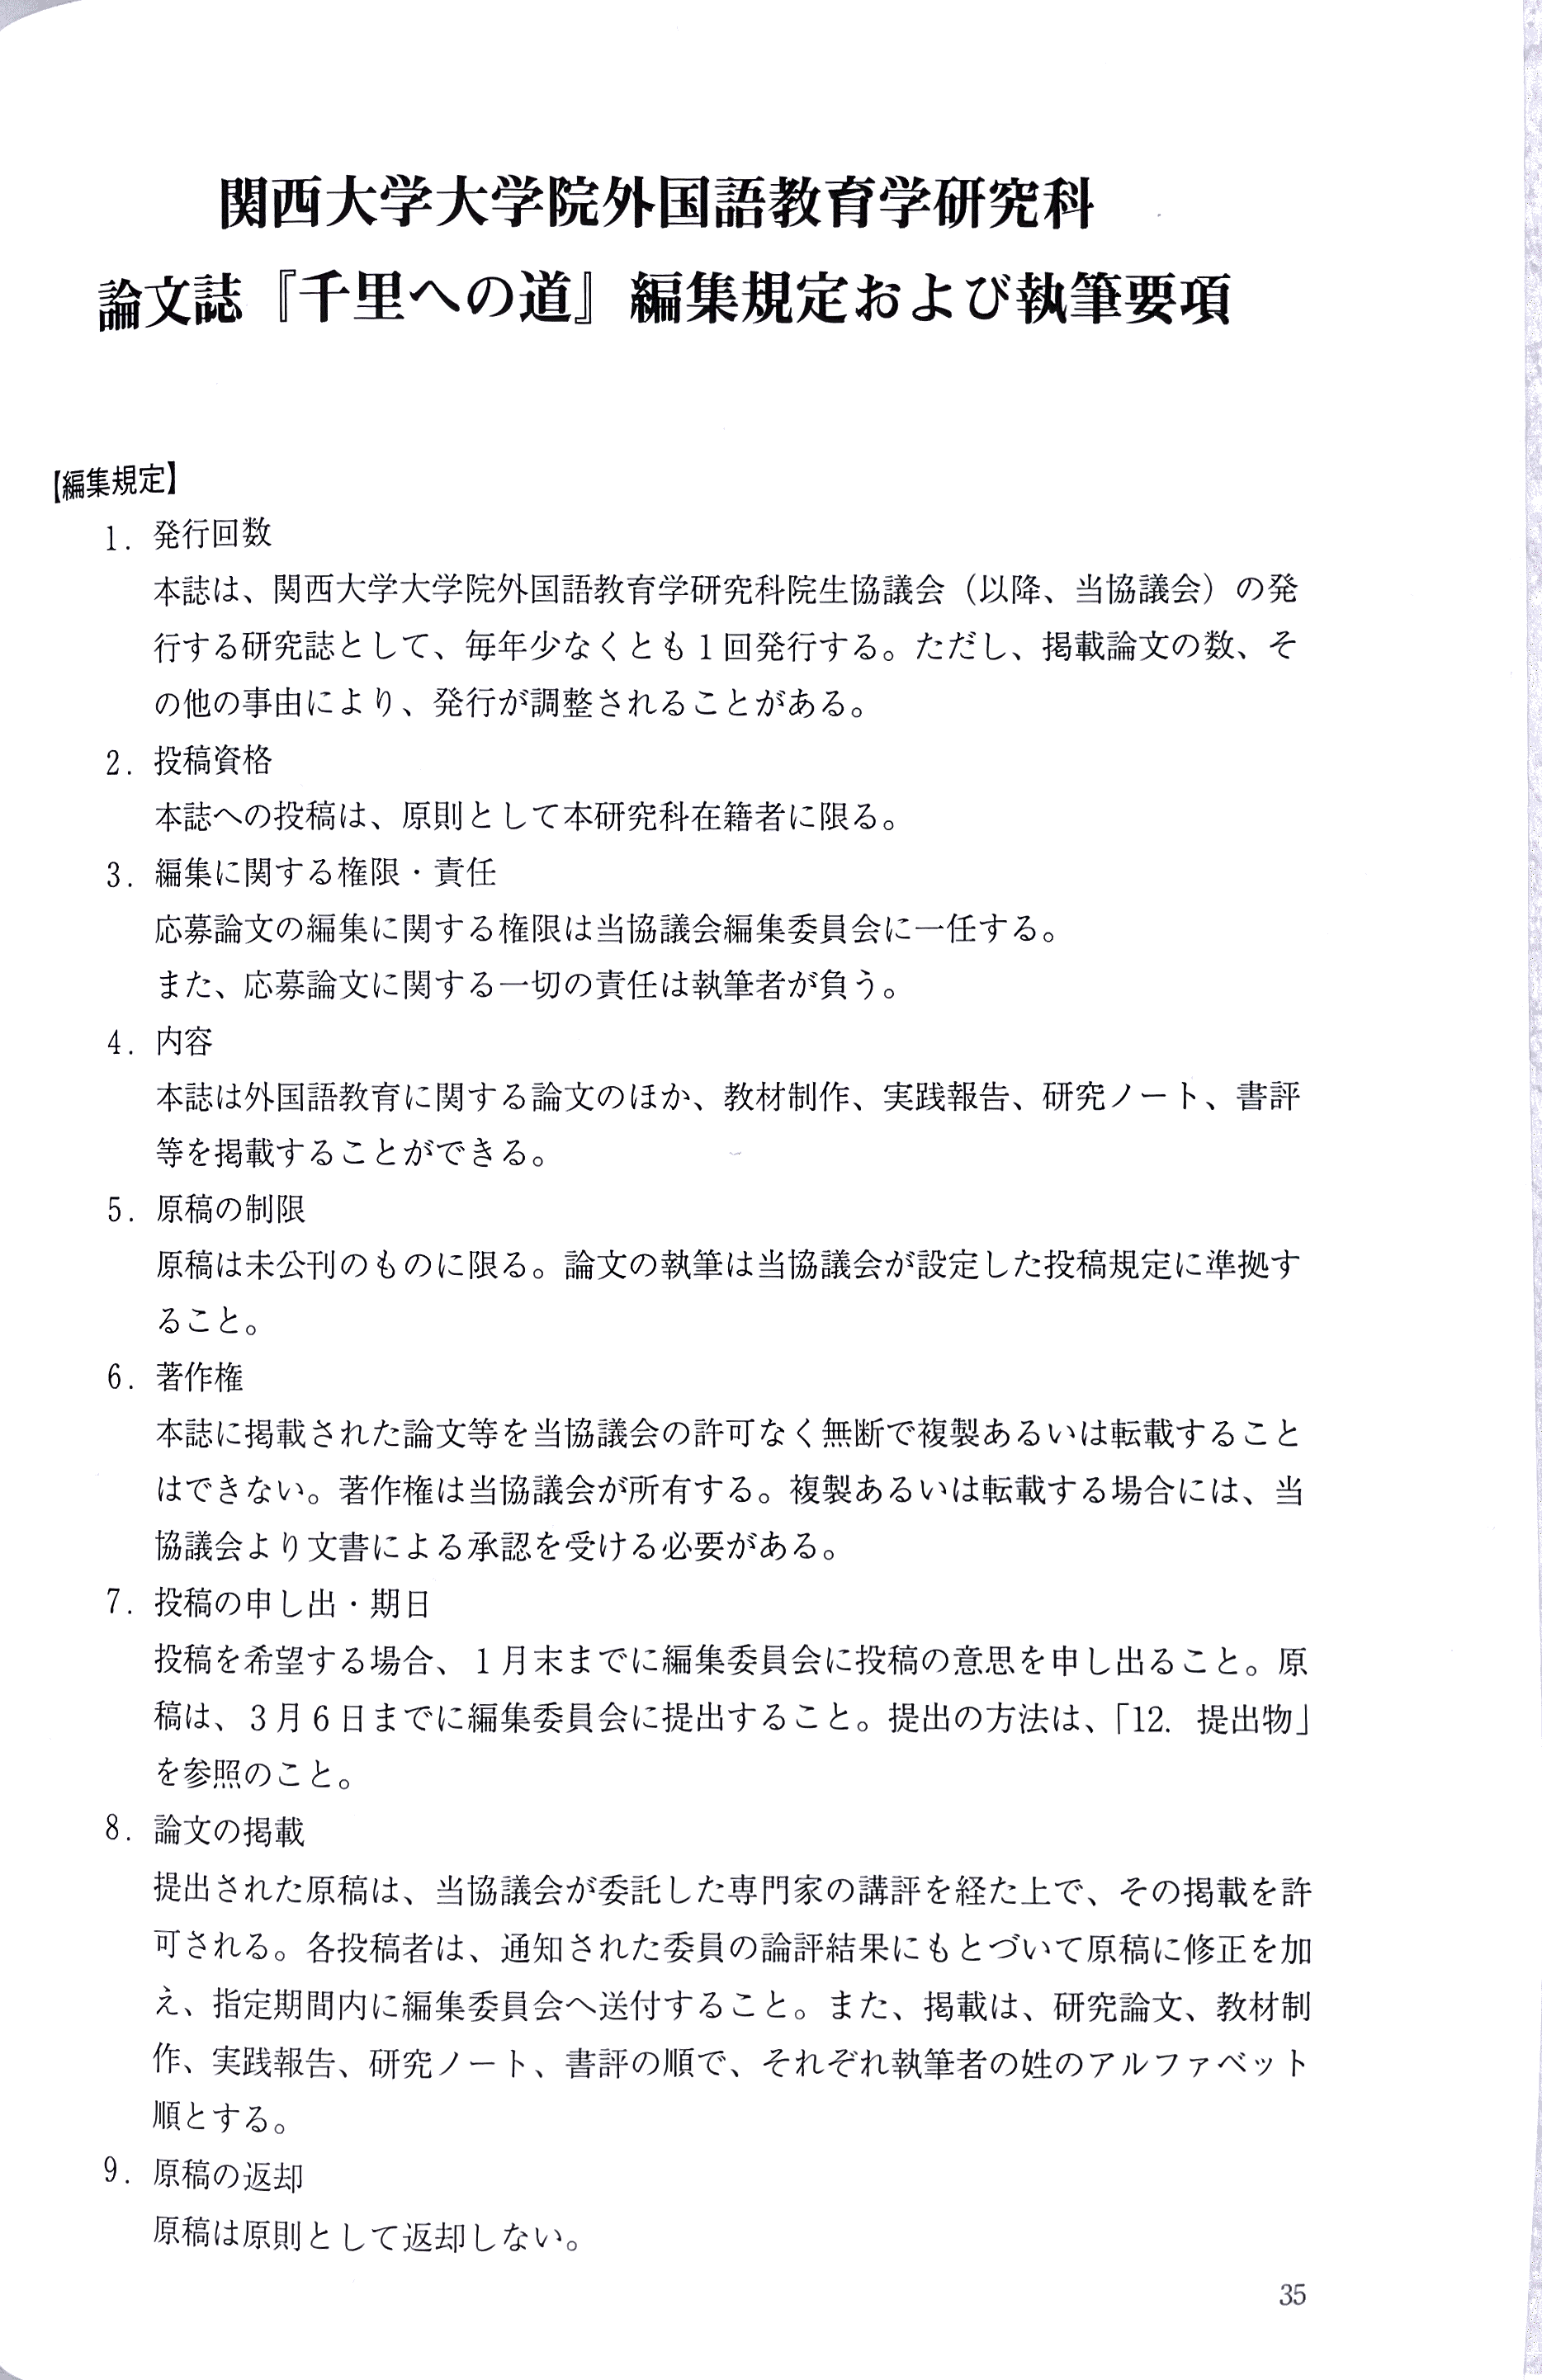
ウェブで公開されている情報が少ないですが,編集規定は以下のようになっています

ポイントとしては,

  • 学生主体で刊行(院生協議会の会員は在籍院生に限られるという規約があります)
  • 研究科に在籍している院生しか投稿できない(費用が院生の学費から捻出されているという理由で修了生の投稿が認められなくなったらしいです)
  • 原稿のタイプは論文だけに限らず割と幅広い(実践報告や書評もある)
  • オンラインで公開されていない

あたりでしょうか。「5. 論文の掲載」の記述がややこしいですね。査読があるとは書いてありませんが,「掲載を許可される」というのは,拒否されることもあるというようにも読めます。ただし,院生の研究成果を報告する様式では「その他紀要等(査読なし)」のカテゴリに「【『千里への道』を含む】」とあります。したがって,無査読という扱いになっているのは間違いないでしょう。

院生にとってのメリット

さて,投稿する院生にとってどういうメリットがあるのかなと考えてみます。まず,論文を書いて出版するということの(私が考える)最も大きな動機は自分の研究を多くの人に届けたい(そしてそのことによって研究者コミュニティやもっと広く社会に貢献したい)ということがあると思います。そう考えると,インターネット上で公開されているかどうかというのは非常に大きな要素になります。学内紀要のようなものであっても,大学の学術レポジトリに登録されていればインターネットに接続した世界中の人たちがアクセスできるわけですから,たとえその「業績的価値」が低く見積もられたとしてもそこに投稿するメリットはあると言えるはずです。なんなら学部生とかに論文を探してこさせるとその多くは学内紀要みたいなものだったりすることもしばしばあります。そういうところに掲載されたものは読者側に価値判断をする力がないといけないことが多く,その判断力に乏しい学生が内容を鵜呑みにしてしまうと良くないという問題がありますが,これは今回の記事の内容からずれるので深堀りしません。

院生忙しい問題

これは特にうちの研究科に特有の問題である気もしますが,院生からすると「そんなとこに書いてる暇ない」というのがありそうな気がしています。フルタイム院生の数があまり多くないので,例えば私が名古屋大学大学院に所属していたときのように常時フルタイム院生が一定数いて,なおかつ毎日研究室に来るほど熱心な院生が多かった(ちなみに研究室に行くことを私の半径数メートル以内では「出勤」と言っていました)環境とは訳が違います。そういった環境なら,就活に求められる業績を目指しつつも,そのレベルではないなという論文を出す先としては無査読の媒体があればそこに出す選択を取れる院生もいました。また,フルタイムだからこそ,「なんか書いて出して」って言われたら書いて出せるくらいの余裕はありました。そして,それが『基礎研報告論集』であったわけです。

基礎研論集の話

名古屋大学大学院の学生の多くは外国語教育メディア学会中部支部に所属していました。私がちょうど入学する前くらいの当時の院生を中心に,その支部学会の研究部会として,「外国語教育基礎研究部会」というものが発足しました。部会の活動の一環として,毎年報告論集を発行しています。この報告論集は学会の所属とはまったく関係なく投稿を受け付けているので(というか部会の活動自体が学会員限定になっていないはず。昔の例会の発表は除く),過去の論集を見ると「え!この人が!」みたいなのがあったりします(2014年度報告論集)。とはいえ,投稿者の多くは名古屋大学大学院の学生が占めてきていたと思います。私も過去に部会長をやっていましたし,投稿の経験があります。過去に「キソケンとはなんだったか」という記事でこの組織がどういうものだったかというのを振り返って書いたりしているので気になる方はそちらをお読みいただくとして,論集に関してはこう書いていました。少し長いですが引用です。

…報告論集についても,「書きたいことを書いて載せられた」という点で自分にとっては良かったです。私は2014年度から2016年度まで,つまり私が博士後期課程に在籍している間は毎年1本を報告論集に投稿していました。キソケンの報告論集は査読なし扱いなので,査読なしだから出しても意味がないというように思う人もいるかもしれません。それはそれで有りだと思います。ただ,私にとってはだからこそ,「書いて残しておきたいもの」ではあるけれども「ジャーナル論文にするような性格のものではないようなもの」を書いて出すのにちょうどよい場所でした(そういうアイデアが当時割とあったとも言えます)。例えば,2014年度には「実験研究の過程と手法のよりよい理解のためにーマイクロリサーチ体験という試みー」と題した論文を出しました。これは,2014年度に静岡で行った学生向けのワークショップについてまとめたものです。マイクロリサーチ体験というのは,事前テスト-処遇-事後テスト-分析-結果-議論といった一連の流れをその場で実演し,研究の進め方についての理解を深めるというものでした。これは,キソケンのメンバーで行ったWSであったので基礎研論集に出したということもありますが,例えばどこかの学会誌に出そうとしたとしてもどの枠で出せばいいのかわかりません。ただ,どうしてもやって終わりではなく文章として形にしておきたかったのです。

2015年度は,「外国語教育研究における二値データの分析ーロジスティック回帰を例にー」というテクニカルレポートを書きました。これは,当時自分で勉強していたことをまとめたかったことと,Rのコードとともに残すことで自分の後輩にも読んでもらいたかったという意図がありました。院生時代にもデータ分析に関する相談を受けることは多く,その際に一般化線形モデルや一般化線形混合モデルを使ったらどうでしょうということがしばしばありました。そのときに,もちろんそれに関する書籍を紹介することもできましたし,グーグル検索すればロジスティック回帰に関する記事はたくさん見つけることができます。ただ,外国語教育研究の例で,Rのコードとともに,ということになるとなかなか例がありませんでした。そこで,「この論文がウェブで無料で公開されていますので読んでください」と言いたかったということです。これも,もちろんmethodological reviewというような形でジャーナルに投稿することもできたかもしれません。私にはその力はなかったというのもありますが,そこにリソースを割くよりも手っ取り早くpublishしたかったというのもあります。

2016年度は査読付き雑誌に2回落ちた論文を横流しする形で出したので,それまでのものとはやや性格は異なります。ただ,これも「教育実践について形になった論文をとにかく出したかった」ということと,同じような研究をやっている方々に読んでもらうためにオープンにウェブで公開したかったということが理由です。実際,自分も関わったプロジェクトに関する論文で引用したりもしました。草薙さんと共著で書いた「外国語教育研究における事後分析の危険性」という論文も,読まれる価値はあるけれども,学会誌等の投稿規定にはそぐわないだろうということがあって基礎研論集に書きました。

「キソケンとはなんだったか」

院生の業績ハードルもあがってる(下がってる?)

これは私たち(mid 30世代。いいですか私達がもうmid 30ですよ)世代よりも下の世代で顕著になってきているのかなと思います。海外の大学院でPh.Dをやっていて,院生時代から国際ジャーナルにどんどん論文を出している世代と同世代の国内の院生は結構プレッシャーに感じているところもあったりするんじゃないかなと思っています。昔(私が大学院生の頃とかそれより前も多分)なら院生で国内全国誌に通っていればとりあえずはまあ院生としてはいい方だという認識もあったように思います。ただ,今では院生でも国際雑誌に投稿するのは何も珍しくないことになってきているように思います(私も投稿自体は院生時代に何回かした経験があります)。そうなると,それが「当たり前」のような雰囲気になっているところがあるような気がします。ある意味では,国際誌投稿のハードルが下がっていると捉えることもできるとは思いますが,自分が院生時代にその環境だったらどうだっただろうと思うと,きついよねぇと思います。御存知の通り,どこに投稿するにせよ国際雑誌投稿は出版までにかかる査読のプロセスにかかる労力がすごいです。最近はOpen Data, Open Materialとか事前登録とか国際雑誌の基準自体もあがっていますから,そこに出そうと思ったら査読なしのところに出している余裕なんかあるかいなとなりますよね。

また,もしそこに出せなかったとしても,査読付きの国内誌や地方学会紀要に出すという判断も当然理解できます。特に,うちの研究科では博士号の審査にかかるときに「いいとこ」に載っていることが推奨されるので,査読なしの論文に手をかける暇なんてないでしょうね。私の記憶が正しければ,私が名古屋大学大学院国際開発研究科で博士号をとったときはそもそも博士論文の内容が査読付き雑誌に載った論文の内容に基づいていることすら要件ではなかったと思います。査読付き雑誌に2本?だったか論文が掲載されたことがあるというのは要件だったと思いますが。このことは私が着任した1年目か2年目に研究科委員会でも話題になったように記憶しています。要するに,「いいとこ」に載っている論文の内容がベースなら博士論文の質も担保されるでしょうというようなロジック。それ自体は私も十分理解できます。

それに加えて,上述のようにそもそもフルタイムの院生が少なく,博士号取得にかかる期間も長い人が多いわけですから,より一層とにかく学位取得に全エフォートを注ぎ込まないといけないという状況になっているのだと思います。そういう環境に身を置いていたら,そりゃあ査読なしで公開もされない学内紀要に投稿なんてしないという判断を責められないですよね。だってその仕組みをつくっているのは教員なんですから。

先輩・後輩の縦横つながり問題

また,そういう院生が自分の学位論文取得に注力せざるを得ない状況というのはもう一つ,縦の関係の意味でもあんまりよくないんだろうなと思います。院生時に論文を出版できるかどうかは,教員の引き上げかもしくは院生同士の切磋琢磨,この2つの要因が大きいのではと個人的に思っています。この中で後者の部分においては,(院生指導していないので実態はよくわかっていないですが),少なくとも自分が経験した大学院生活とはずいぶん違う環境なんだろうなとは思っています。フルタイムの院生が少ないと,そもそも院生同士のつながりがそこまで強固に形成されにくいんだと思います。私がいた名古屋にいた頃は「全寮制なんでしょ?」といじられるほどに縦横のつながりが外部からも認識されていたわけですが,おそらくうちの研究科にはそういうものはなさそうです。そうなると,先輩が後輩の面倒を見て論文の出版を後押しするみたいなことや,院生同士で「なんかネタない?」とか,「あれちょっと書いてまとめとこうや」みたいなことにもなりづらいんだと思います。

大学院を担当される先生方は授業担当という意味でも,学内のその他の業務担当という意味でも私のような若手(学内だと次の公募で私より下の方が来なかったらまだ私が当分は最若手では…?)よりも業務量が多いです。となると,そういう先生たちも学位論文指導以外の面で院生の研究をサポートするところまでできるというようにはあまり思えません(繰り返しますが実際に先生方がどうなさっているかは知りません)。また,教員側からしても投稿するメリットを学生になかなかアピールしづらかったり,そもそもそれを言いづらい(学位論文に注力してもらわないと困るわけなので)という現状もあると思います。

そもそも査読なし媒体自体の価値が見出しづらい?

メソ研論集も一時期すごい活気があったように思いますが,あれも投稿が集まりづらいのは時代なのかなぁと思ったりもします。もちろん,10年前くらいに今の私たちくらいの年齢でイケイケだった人たちが今や学内組織や学会組織を回す側になり,研究以外の業務で忙しくなってしまったので余裕がなくなってしまったというのもあるでしょう。メソ研論集や基礎研論集はそれでもインターネット上でオープンに公開されていますから,それでもなかなか集まらないとなったらインターネット上でも公開されていないものに投稿が集まらないなんて当然では?と思います。なんのために発行しているの?という媒体そのものの価値を見直さない限りは投稿も増えることは見込めないでしょう。私としては,上で自分の過去記事を引用したような部分が査読なし媒体の存在価値だと思っていますので,利用する機会がなくなったりはしないかなと思います。

ただし,やっぱり広く読まれるのは国際誌だと思っていて,例えば全国英語教育学会紀要(ARELE)に載ってもたいして引用されないですよね。自分のやった研究が学術コミュニティの議論に貢献しているのかなと思うので,よほど理由がなければ(あるいは国際誌に出すほどではないかぁという質のものでなければ)国際誌を基本的には目指してやるだろうなぁと思います。先日届いたARELEの編集後記に投稿数が減っているみたいなことが書いてありましたが,昔ならARELEに出していたようなものを国際誌に投稿するようになっているんだと思います。コロナで研究活動が滞っているということも原因としてなくはないでしょうが,今後も国内の紀要は全国誌・地方誌,査読ありなしに関わらず存在意義を突きつけられていくのではないでしょうか。

公開はまずい的議論

査読なしで公開することに関して,「やばいのが公開されたらやばい」というロジックで公開に後ろ向きな人がいるのだろうなぁとか,そういう議論がされてきたこともあるだろうなぁということは想像できます。つまり,公開しないのは質が低いから,みたいな話です。一理あるとは思いますが,別に査読がないからといって著者以外の誰も原稿に目を通さずに公開に至ることはないわけですし(「専門家の講評」があると編集規定に書かれていますし),教員や院生同士で投稿前の原稿をそれなりのレベルに引き上げるプロセスをすればいいだけでは?と個人的には思います。教員側にその余裕がないのであれば,院生同士が自主的に切磋琢磨しあえる環境を作るようにしていけばいいですし,それも難しいのであれば院生限定でしか投稿できない媒体を維持すること自体が難しいという結論になると思います。

さらに身もふたもないことを言えば,公開されたからといってそんなにたくさん「読まれない」とも思います。有名な研究者の書いたものならまだしもどこの者ともしれぬ院生が出した論文であれば,データベースに載ったりしない限りは研究者の目に引っかかることもあまりないでしょう。研究者の目に引っかからないということはつまり,厳しい目で読まれることもないわけですから,「こんなやべえ論文出してる組織やべえな」ってなることもあまりないように思います。多くの場合は,へーこんな研究やってる院生がいるのねーとか,ここの院生は頑張ってるねーくらいの感じで目次やアブストを眺めるくらいなんじゃないでしょうか。基礎研論集だってちゃんとダウンロードして中身読んだらこれ大丈夫か?みたいなのも見たことありますよ。それでどういう評判になっているかは私のところに聞こえてくることはないですけれども。

それに,審査のプロセスがあった上で「やばい」のがあったら審査した側の責任も問われるべきだと思いますが,無査読であれば(よほど倫理的にやばいみたいなのを覗いて)研究の質が低い・論文の質が低い,みたいなものの責任を負うのは執筆者自身でしょう(編集規定にも「応募論文に関する一切の責任は執筆者が負う」とあります)」。そのことで組織の評判が落ちることを気にするのであれば,やっぱり教員が介入するなり院生同士のネットワークを強化するなりして,院生の投稿を支援する仕組みづくりが欠かせないはずです。あとは,大学院の授業のタームペーパーとして論文のベースになりそうなものを求める授業があるかどうかということも院生の投稿を促すことにつながると思います。実際,名大ではそういうケースでMの院生がタームペーパーをもとに論文化することがありましたし,それは今でもおそらくそうなっていると思います。

おわりに

一言でまとめると,院生が「出してみようかな」と思える環境にそもそもなっていないというか,それを後押しする要素が欠けているということに尽きるのではないかと思います。よって,査読なしであっても院生が投稿しようと思うような媒体にすること(ウェブ公開)と,組織としてそれを支援する仕組みを作ること(教員のサポート&院生同士の切磋琢磨)が取り組むべき課題かなというのが私の結論です。

なにをゆう たむらゆう。

おしまい。

学生からの質問と回答の蓄積

はじめに

学生からの英(単)語学習についての質問を受けつけるというのを同僚の先生と一緒に担当している授業の学期の最初の方で毎年やっています。昨年度から,個別に返すのではなく学生からの質問とこちらからの回答をセットにしてQ&A集としてまとめ,それを学生と共有して資料にすることにしました。

なんか今年はコメントの質&量が違う?

この科目を担当しだしたのは着任2年目(2019年度)からでした。2019年と2020年は,学生からの質問は個別にLMS上で返すようにしていました。2021年は,質問と回答をまとめてWordファイルにして,そこにどんどん追記していく形にしました。それをクラウド上で学生が見れるようにしていて,今年度は,昨年度作ったQ&A集を見てから学生にコメントを求める形式に変更しました。昨年度以前も鋭いコメントを書いてくる学生はちらほらいましたが,今年度はコメントの質・量ともに昨年度よりあがっているような感覚が個人的にあります。もちろん,全体の中でいうとやっつけっぽいコメントがあったりとか,本当に資料を見てから書いているのかな?と思うコメントもあります。ただそれ以上にびっしりコメントを書いている学生が多いような印象がするのです(LMSからダウンロードして昨年度と今年度の文字数を比較したらどちらが多いかわかりますけどめんどくさいのでそこまではしません)。

1年生のこの時期は非常に真面目なので,同じ課題をもう少し時期をずらしてやったら全然違う結果になるだろうなとは思いますけどね。ただ,鉄は熱いうちに打てじゃないですけど,そうやって一生懸命書いてくれたことにたいして,こちらも全力でぶつかろうじゃないかという気持ちでいます。その中で,私が研究しているようなことだったり,あるいは言語そのものだったりに興味を持つ学生が少しでも増えてくれたらいいなと思います。

自分自身の研鑽にもなる

私は着任5年目ですが,英語科目(と基礎ゼミ)以外の専門科目を教えたことがないので,学生からの質問に対して,自分の持っている専門的な知識で答えるということがあまりありません。専門科目を教えていらっしゃる先生方は日常的に自分の専門に関わる質問を学生から受けているのだろうなと思うと,専門科目を担当すること自体が研究的な意味での自分自身の研鑽になるなと思いました。自分と同年代でそういう(専門科目を担当する)機会があるという話を聞くと単純に羨ましいなと思います。もちろん授業の準備は大変でしょうけど。ただ,専門科目の授業準備は研究とも繋がっているはずなので,英語の授業の準備とはまた全然違いますよね。自分がそういう科目を任されていないのは,それだけの知識があるとみなされていない(研究者としての力量が不足している)ということだと思うので,講義を任せてもらえるように勉強・研究に励みたいと思います。

いつか講義資料になったらいいな(希望的観測)

さて,冒頭で紹介したQ&A集の中には,研究に言及しながら質問に答えている部分もあります。そういう部分を書いていると,昔読んだ論文をまた読み直したり,あるいは関連する新しい論文を探したりして,結構楽しいです。今は私がそうやって時間を費やして回答したものがどれだけの学生に読まれているのかということはわかりませんが,いずれ,今書いているようなものが自分が専門の授業を担当したときの講義資料の一部になったらいいなと思ったりしています。

1年生に向けて書いているということもあって,柔らかめの言葉遣いで文章を書いています。ただ,いつか講義資料になったらいいなということを念頭に置きながら文章を書こうとすると,内容的な部分でそういう講義資料の一部になってもおかしくないようなクオリティの文章を書かないといけないという気持ちになります(気持ちになるだけで実際にクオリティがあがるかどうかというとまた別の話なんですが)。

絶対に読まないといけない資料ではなく,「読んでね☆」くらいで提示しているものなので,まあ興味のある学生しか読まないのだろうとは思いますけれど,それでもなんていうかこういうところでしか自分の研究者としての知識を授業にダイレクトに反映させる機会もないので,なんか気合いが余計に入っちゃうんですよね。正直言ってそこをサボったところで授業の質が落ちるわけでもないと思うのですが,なんか楽しいから頑張っちゃうんですよね。いつか「あーあのとき頑張っててよかったナイス自分」と思える日が来るといいなと思います。

なにをゆう たむらゆう。

おしまい。

WebClassのtips

自分の所属先のFDで,3月10日にWebClassというLMSのtips紹介みたいなことをやりました。他の大学でもWebClassを使っているところがあれば参考になるかもしれないなと思い,当日使ったファイルの共有リンクを貼っておきます。

https://www.dropbox.com/s/khjzajqeys3qbs8/2022MarchFD_Tamura.html?dl=0

HTMLファイルになっていて,Dropbox上でのプレビューが見れないと思いますので,ダウンロードしてご自身のデバイスで御覧ください。

大学でどういった運用をしているかや設定等によって使えない機能があったり見た目が違うということもあるかと思いますのであくまで参考としてください。細かいことについては私は開発者や導入者ではないのでわかりかねます。その点ご了承ください。

なにをゆう たむらゆう。

おしまい。

[R] 初心者向け pivot_longer関数で縦型変換

はじめに

以前(というかかなり昔),tidyrやdplyrについての記事を書きました。

どちらの記事を書いたときからもだいぶ月日が経っていて,dplyrのアップデート等もあって色々とやり方が変わっているのですが,自分自身が研究で分析をする際にアップデートしていたことをブログ記事には反映させられていないので,上の2本の記事のアップデート版のようなことを書いておこうと思います。

まずはサンプルデータ

#事前・事後・遅延事後でCAFのデータを取ってるというデザイン
pre.fluency <-rnorm(50,mean=10,sd=2)
pre.accuracy<-rnorm(50,mean=7,sd=2)
pre.complexity<-rnorm(50,mean=4,sd=2)
post.fluency<-rnorm(50,mean=14,sd=4)
post.accuracy<-rnorm(50,mean=10,sd=3)
post.complexity<-rnorm(50,mean=7,sd=2)
delayed.fluency<-rnorm(50,mean=12,sd=2)
delayed.accuracy<-rnorm(50,mean=8,sd=1)
delayed.complexity<-rnorm(50,mean=6,sd=1)

#それぞれの列を横にくっつける
dat<-cbind(pre.fluency,pre.accuracy,pre.complexity,post.fluency,post.accuracy,post.complexity,delayed.fluency,delayed.accuracy,delayed.complexity)
dat<-as.data.frame(dat) #データフレーム型に変換
dat$subject<-rep(1:50) #実験参与者のID列をつける

とりあえずこんな感じでいまデータを持ってるとする

head(dat)
##   pre.fluency pre.accuracy pre.complexity post.fluency post.accuracy
## 1    9.344978     3.921626      4.5778491    13.932376      2.241629
## 2    9.126920     7.307178      3.2309289    13.624622     12.813440
## 3   13.433524     6.048270      5.0082008     7.932601     11.832851
## 4   11.937755     5.859142      0.6414096    11.289177      7.009059
## 5    7.913083     5.748651      2.6099159    17.933721     10.765706
## 6    8.683515     4.363661      5.4608116    16.550468     16.483160
##   post.complexity delayed.fluency delayed.accuracy delayed.complexity subject
## 1        9.381369       10.628923         6.929672           7.923673       1
## 2        4.485729       14.456886         9.048825           5.306266       2
## 3        7.534226       13.031400         7.144670           7.781451       3
## 4        8.076248       12.390157         9.247418           6.244443       4
## 5        8.702016        9.604130         7.530200           5.927892       5
## 6        8.973912        8.060271         8.188526           6.458383       6

縦横変換

昔の縦横変換は,gatherでやっていました。現在は,pivot_関数を使います。その名の通り,縦長(long型)にするのがpivot_longer関数で,横長にするのがpivot_wider関数です。

library(dplyr)
dat %>%
  tidyr::pivot_longer(cols = 1:9)
## # A tibble: 450 × 3
##    subject name               value
##      <int> <chr>              <dbl>
##  1       1 pre.fluency         9.34
##  2       1 pre.accuracy        3.92
##  3       1 pre.complexity      4.58
##  4       1 post.fluency       13.9 
##  5       1 post.accuracy       2.24
##  6       1 post.complexity     9.38
##  7       1 delayed.fluency    10.6 
##  8       1 delayed.accuracy    6.93
##  9       1 delayed.complexity  7.92
## 10       2 pre.fluency         9.13
## # … with 440 more rows

colsのところでどの列をまとめるかという指定をします。ここの指定は,上のやり方だと数字で列指定(1列目から9列目)としています。この部分はc()関数を使って文字列で指定してもいいですし,列指定のときに使えるstarts_with()やcontains() なんかもできます。例えば,まあこれはあくまで偶然そうなだけですけど,ここではまとめたい1列目から9列目はすべて”y”で終わっているので,以下のようにすることもできます。

dat %>% 
  tidyr::pivot_longer(cols = ends_with("y"))
## # A tibble: 450 × 3
##    subject name               value
##      <int> <chr>              <dbl>
##  1       1 pre.fluency         9.34
##  2       1 pre.accuracy        3.92
##  3       1 pre.complexity      4.58
##  4       1 post.fluency       13.9 
##  5       1 post.accuracy       2.24
##  6       1 post.complexity     9.38
##  7       1 delayed.fluency    10.6 
##  8       1 delayed.accuracy    6.93
##  9       1 delayed.complexity  7.92
## 10       2 pre.fluency         9.13
## # … with 440 more rows

また,まとめたくない列を”!“で指定することもできるので,今回のようにまとめないでほしい列が少ないという場合については,次のようにも出来ます。

dat %>% 
  tidyr::pivot_longer(!subject)
## # A tibble: 450 × 3
##    subject name               value
##      <int> <chr>              <dbl>
##  1       1 pre.fluency         9.34
##  2       1 pre.accuracy        3.92
##  3       1 pre.complexity      4.58
##  4       1 post.fluency       13.9 
##  5       1 post.accuracy       2.24
##  6       1 post.complexity     9.38
##  7       1 delayed.fluency    10.6 
##  8       1 delayed.accuracy    6.93
##  9       1 delayed.complexity  7.92
## 10       2 pre.fluency         9.13
## # … with 440 more rows

「まとめる」という感覚がいまいちよくわからないなぁとか,どの列を「まとめ」て,どの列は「まとめ」なくていいのかというのがピンと来ない場合には,次のように考えてください。

分析の際に従属変数(応答変数)となる列をまとめる

さて,今の段階ではまとめた際の列名が”name”になっていて,数値の部分が”value”という列名になっていますよね。ここも次のように指定できます。

dat %>% 
  tidyr::pivot_longer(!subject, names_to = "variable", values_to = "score")
## # A tibble: 450 × 3
##    subject variable           score
##      <int> <chr>              <dbl>
##  1       1 pre.fluency         9.34
##  2       1 pre.accuracy        3.92
##  3       1 pre.complexity      4.58
##  4       1 post.fluency       13.9 
##  5       1 post.accuracy       2.24
##  6       1 post.complexity     9.38
##  7       1 delayed.fluency    10.6 
##  8       1 delayed.accuracy    6.93
##  9       1 delayed.complexity  7.92
## 10       2 pre.fluency         9.13
## # … with 440 more rows

ただ,今回のケースではまとめた列に”pre”, “post”, “delayed”というテスト実施時期(test)という要因と,“complexity”, “accuracy”, “fluency”という測定値の要因が混在していますね。よって,あまり”name”の列名を変えることは意味がありません。むしろ,この列を分割してそれぞれの列に名前をつける必要があります。この列分割をseparate関数で行うという点は私が以前ブログ記事を書いた際と同じです。というわけで,次のようにします。

dat %>% 
  tidyr::pivot_longer(!subject) %>% 
  tidyr::separate(name, c("test","measure"), sep = "\\.")
## # A tibble: 450 × 4
##    subject test    measure    value
##      <int> <chr>   <chr>      <dbl>
##  1       1 pre     fluency     9.34
##  2       1 pre     accuracy    3.92
##  3       1 pre     complexity  4.58
##  4       1 post    fluency    13.9 
##  5       1 post    accuracy    2.24
##  6       1 post    complexity  9.38
##  7       1 delayed fluency    10.6 
##  8       1 delayed accuracy    6.93
##  9       1 delayed complexity  7.92
## 10       2 pre     fluency     9.13
## # … with 440 more rows

これで,完璧ですね。と思いきや…!実はpivot_関数には”name_sep”という便利な引数があります。これはどういう時に使うかと言うと,まとめた際に一つの列に複数の要因が混在してしまうときに,それを指定した区切り文字によって分割するために使います。まさに上で起こった問題ですよね。テスト実施時期と測定値が一緒の列になっていたのをseparate関数で分割したわけですが,なんとseparateを使わなくても縦型に変換する段階で分割までできてしまいます。

dat %>% 
  tidyr::pivot_longer(!subject, names_to = c("test", "measure"), names_sep = "\\.", values_to = "score")
## # A tibble: 450 × 4
##    subject test    measure    score
##      <int> <chr>   <chr>      <dbl>
##  1       1 pre     fluency     9.34
##  2       1 pre     accuracy    3.92
##  3       1 pre     complexity  4.58
##  4       1 post    fluency    13.9 
##  5       1 post    accuracy    2.24
##  6       1 post    complexity  9.38
##  7       1 delayed fluency    10.6 
##  8       1 delayed accuracy    6.93
##  9       1 delayed complexity  7.92
## 10       2 pre     fluency     9.13
## # … with 440 more rows

このときのポイントは2点あります。1つは”names_to”で列名を2つ指定すること。縦型変換の際に列の分割もするので,ここでのnames_toの指定は分割後の列名とします。もう一つは,区切り文字は正規表現を受け付けるということ。区切り文字がドット(.)なので,ここでnames_sep= “.”としてしまうと,正規表現におけるドットだと認識されてしまいます。これでは任意の1文字ですので,列名がうまく分割されずに以下のようになってしまいます。

dat %>% 
  tidyr::pivot_longer(!subject, names_to = c("test", "measure"), names_sep = ".", values_to = "score")
## Warning: Expected 2 pieces. Additional pieces discarded in 9 rows [1, 2, 3, 4,
## 5, 6, 7, 8, 9].
## # A tibble: 450 × 4
##    subject test  measure score
##      <int> <chr> <chr>   <dbl>
##  1       1 ""    ""       9.34
##  2       1 ""    ""       3.92
##  3       1 ""    ""       4.58
##  4       1 ""    ""      13.9 
##  5       1 ""    ""       2.24
##  6       1 ""    ""       9.38
##  7       1 ""    ""      10.6 
##  8       1 ""    ""       6.93
##  9       1 ""    ""       7.92
## 10       2 ""    ""       9.13
## # … with 440 more rows

したがって,正規表現ではありませんよということを追記する必要があります。このことをエスケープするなんて言いますが,Rにおけるエスケープは “\\”です。一般的にはエスケープは”\“ですが,R上では2つ重ねないといけないことに注意が必要です。

おわりに

とりあえず,long型に変換する作業をこの記事では説明しました。少し長くなってしまったので,記述統計を出すという話はまた別の記事にしたいと思います。

なにをゆう たむらゆう。

おしまい。

追記(2022.03.16)

従属変数を3列待ちにしたい(横長にしたい)

よく考えたら,分析するときはcomplexity, accuracy, fluencyの3つの列があったほうが便利ですよね。ということで,その形に変形させましょう。ここで,横長に変換するためのpivot_wider関数を使います。“names_from”の引数で「分解」したい列を指定します。ここでは,accuracy, complexity, fluencyの入っている“measure”の列を「分解」して横長にするので,“measure”を指定します。あとは,横長にしたときに持ってくる数値がどこに入っているかを“values_from”の引数で指定します。これは“score”に入ってますから,これを指定すればいいですね。というわけで,次のようになります。

dat %>% 
  tidyr::pivot_longer(!subject, names_to = c("test", "measure"), names_sep = "\\.", values_to = "score") %>% 
  tidyr::pivot_wider(names_from = "measure", values_from="score")
## # A tibble: 150 × 5
##    subject test    fluency accuracy complexity
##      <int> <chr>     <dbl>    <dbl>      <dbl>
##  1       1 pre       10.1     10.0        3.97
##  2       1 post      15.8      8.50       9.81
##  3       1 delayed   15.5      8.59       4.67
##  4       2 pre       12.0      6.40       1.03
##  5       2 post       6.90    10.1        7.30
##  6       2 delayed   15.0      8.54       7.70
##  7       3 pre        9.07     8.49       2.78
##  8       3 post       7.11    10.2        8.55
##  9       3 delayed   10.7      7.97       5.54
## 10       4 pre       12.5      6.03       2.26
## # … with 140 more rows

もしも,fluency, accuracy, complexityなどの順番が気になる場合は,select関数で指定してください。

dat %>% 
  tidyr::pivot_longer(!subject, names_to = c("test", "measure"), names_sep = "\\.", values_to = "score") %>% 
  tidyr::pivot_wider(names_from = "measure", values_from="score") %>%
  dplyr::select(subject, test, complexity, accuracy, fluency)
## # A tibble: 150 × 5
##    subject test    complexity accuracy fluency
##      <int> <chr>        <dbl>    <dbl>   <dbl>
##  1       1 pre           3.97    10.0    10.1 
##  2       1 post          9.81     8.50   15.8 
##  3       1 delayed       4.67     8.59   15.5 
##  4       2 pre           1.03     6.40   12.0 
##  5       2 post          7.30    10.1     6.90
##  6       2 delayed       7.70     8.54   15.0 
##  7       3 pre           2.78     8.49    9.07
##  8       3 post          8.55    10.2     7.11
##  9       3 delayed       5.54     7.97   10.7 
## 10       4 pre           2.26     6.03   12.5 
## # … with 140 more rows

この変換後のデータを別の変数に保存するのを忘れずに!

dat2 <- dat %>% 
  tidyr::pivot_longer(!subject, names_to = c("test", "measure"), names_sep = "\\.", values_to = "score") %>% 
  tidyr::pivot_wider(names_from = "measure", values_from="score") %>%
  dplyr::select(subject, test, complexity, accuracy, fluency)

head(dat2)
## # A tibble: 6 × 5
##   subject test    complexity accuracy fluency
##     <int> <chr>        <dbl>    <dbl>   <dbl>
## 1       1 pre           3.97    10.0    10.1 
## 2       1 post          9.81     8.50   15.8 
## 3       1 delayed       4.67     8.59   15.5 
## 4       2 pre           1.03     6.40   12.0 
## 5       2 post          7.30    10.1     6.90
## 6       2 delayed       7.70     8.54   15.0

手元に蓄積されることと共有されることのバランス

はじめに

ひと月前くらいからぼんやり考えていて,ブログにまとめようと思っていてなかなか時間が取れなかったことを書きます。

教科書に何かを書き込めるということは,書き込んだことがいつも学習者の手元にあり,それがいつでもその学習者自身にとって閲覧可能な状態であるということです。その一方で,その状態ではクラスメイトと学習の過程や成果を共有することは難しくなります。そんなジレンマの話。ちなみに,語学授業のことを念頭に置いています。

教科書(または配布資料)への書き込み

語学の教科書には,なにかと空欄があって,そこを埋めることが学習となることがよくあります。数学なんかだと問題自体は教科書にあって,その計算の過程なんかはノートに書いていくみたいなことが多いような自分の小中高の記憶がありますが(大学はどうなんでしょう?),語学の教科書はノートというものを学習者が教科書とセットで使うということがたぶんあんまり想定されていないですよね。中高の英語の教科書はいわゆる「本文」の扱いが大きいからか,大学で使われるような教科書よりも書き込みが求められる部分が少ないようなイメージもあります。とはいえ,教科書に書き込む(それが穴埋めだったり選択肢を選ぶものだったりあるいは短文回答だったりする)ことは語学の授業では日常的に観察される光景だと思われます。

教科書に書き込まれた答えを共有するのは口頭で周りの人と話し合ったり,あるいは教員が学習者を指名して発言することで行われることが多いと思います。その「共有」という営みは,教室の授業の時間の中で行われ,(真面目にメモを取ったりしていない限り)その場で流れていってしまうことになります(そして多くの場合,間違っていたら直す程度で他の人のコメントなりをメモする学習者はかなり少ないと想定されます)。多肢選択の答え合わせ程度であれば,それでも特に問題はないと思いますが,答えが一つに定まらないような問いに答えるようなケースであれば,できるだけその共有がどこかに「ストック」されているほうがいいなと思うことがよくあります。

一方で,教科書をベースにしていても,いわゆる「ワークシート」と呼ばれるような配布物を授業中に配布して,そこに何かを書き込ませる形で授業を進めていく先生も多くいらっしゃると思います。教科書をより発展させたスピーキングやライティングの活動だったり,あるいは教科書とはまったく独立したものをワークシートとして提供したりするケースです。この場合も学習者はそのワークシートに何かしらを書き込み,上で述べたのと同じような共有の過程が授業の中で行われるでしょう。

いずれの場合においても,ペアワークやグループワークを通じてクラスメイトとの意見の交換が求められ,それをメモするスペースが確保されているような場合にはクラスメイトの意見と自分の意見が同じ場所に「保存」されることになります。そうでなければ,先述のように共有のプロセス自体は授業中に行われていてもその共有物自体はそこで流れていってしまうでしょう。

LMSやクラウドサービス等を通じての共有

コロナ禍で「オンライン授業」が全国的に広がったことを背景に,学習者が学習に取り組んだその成果物が教科書に書き込まれたままでは以前のように教室内での共有が難しくなりました。そこで,それを補完する目的でLearning Management System(LMS)やDropboxやGoogle Drive等のクラウドサービスを通じて成果物の教員-学習者間,そして学習者同士の間で共有されるようなケースもでてきたと思います。こうしたオンライン上での共有サービス利用のメリットは,(その仕組み構築のやり方によっては)共有されたものが「流れていってしまう」ことを防ぎ,「ストック」されていくことです。

私の勤務先の大学では,2020年度の秋学期,そして一部オンライン授業もありましたが2021年度も基本的には対面授業が行われました。オンライン授業で得られたそうしたLMSやクラウドサービス等を対面授業でも継続して活用し,対面授業の中でも共有のプロセスが流れていってしまわないようにされた先生方もいらっしゃったのではないでしょうか。

このとき,例えばこれまでであれば教科書に書き込んでいたようなものをLMS上に移植することで,各学習者の答えが教室内だけではなくオンライン上で共有され,そしてそれがいつでも学習者にとってアクセス可能な状態にできるというメリットが生まれます。こうした方法を利用することによって,正答・誤答があるような問題であれば,その場で誤りの傾向に対してフィードバックができるというメリットも生まれます。

オンライン上での共有の問題

ところが,いつでも学習者にとって利用可能であるということはメリットである一方で,デメリットもあります。なぜなら,そこ(オンライン上の共有された場所)にアクセスしない限りは利用可能性がないという点です。もちろん,LMS上にログインしてその授業のページを開いて教材をクリックするとか,あるいは教員から送られてきたリンクをクリックすることのハードルがそこまで高いとは言いません。そうは言っても,手元にある教科書を開いて閲覧することに比べると圧倒的にオンライン上へのアクセスを手間だと思う学習者は多いでしょう。そうなると,自分の学習のために共有されたものが教員側の想定のように活用される可能性は,そうした活動を教員側が用意して導かない限りは限りなく低くなってしまうでしょう。

さらに,多くの場合こうした共有物はオンライン上で別々の場所に保存されることがほとんどだと思います。どうやって頑張って工夫をしたとしても,実在物として教科書1冊のなかにまとめられている,あるいはワークシートがファイルにまとめられているというような一覧性を確保することは難しいでしょう。ここに,共有を重視することによってもたらされる弊害が見えてきます。

蓄積と共有のバランス

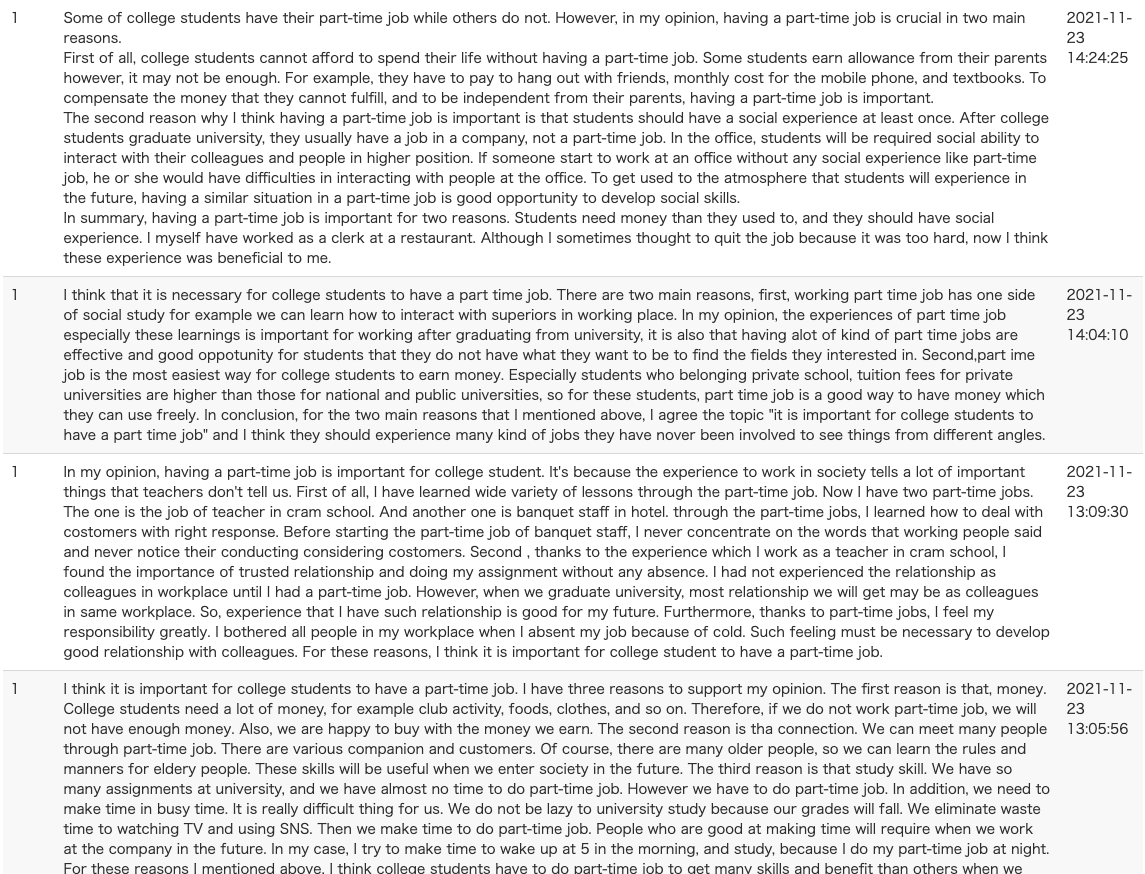
例えば,過去記事で紹介した『Getting Things Done [Book 1] Tasks for Connecting the Classroom with the Real World』(GTD)のUnit6 “Daily scenes”では,最後の活動で自分の学校の中のある場所を描写するライティングの課題が設けられています。この描写課題は教科書に書き込むスペースが設けられていますので,授業内で他の学習者の書いたものを読む機会を与えたりしない限りは共有ができません。じゃあ,ということで,これは教科書に書かせずにLMS上でタイプして提出させる宿題にすることにしたとします。こうすることで,例えば下の画像のような形で他のクラスメイトの書いたものを一覧で見ることができるようになります。

私の担当した授業の一つで課題として出したエッセイ課題の学生のプロダクトの一部(学生からの見え方)

このような共有の形をとることで,クラスメイトの書いたものと自分の書いたものを様々な観点から比較することができます。特に,ライティングのクラスでは(ちなみに上の画像はライティングのクラスではないです),クラスメイトのプロダクトが閲覧可能な状態であることが自身の学習に役に立ったというコメントを多くもらいました。先ほど例にあげた”Daily scenes”のユニットの最後の課題であれば,読んだ上でどの場所についての描写なのかについて答えさせるリーディングの活動につなげることもできます。

一方で,オンライン上で共有させることで教科書自体にはプロダクトが残りません。もちろん,教科書に書いたものを写真にとってその画像ファイルを提出させるという手段はありますが,やはり画像ファイルはテキストよりも一覧性が落ちます(一つ一つファイルを開いて閲覧しなくてはいけないため)。教科書に学習の成果が蓄積されていくことと,その成果をどのような形で共有し,それによってさらなる学習を生み出していくのか,そのバランスというか良い方法を探っていくというのが,2022年度に意識しようかなと思うところです。結局の所,共有についてもただ共有という状態を作るのではなく,そこから学習を生み出す仕掛けを教員側が用意する必要があるだろうなということは感じています。来年度は新しく担当する科目もあるので,そういった仕掛けをどう組み込んでいくのか,この春休みに少し考えてみようと思っています。

おわりに

この記事では,教科書に書き込むことのメリットとデメリットについて,プロダクトの共有と学習成果の蓄積という観点から考えてみました。教科書を作るという経験をしなければ,そしてコロナ禍が続いてオンライン授業が緊急避難的なものではなくalternativeとして機能するレベルにならなければこうしたことにも考えが及ばなかったかもしれないと思います。2021年は,授業のことについて書こうと思っていたのですが,結果としてほとんど授業に関する記事がアップできない年となってしまいました。2022年は少しはそういう記事も書けたらなと思います(控えめ)。

なにをゆう たむらゆう。

おしまい。