カテゴリー別アーカイブ: 研究

明示的・暗示的知識に関する新しい論文が出版されました

はじめに

福田さんと一緒に書いた明示・暗示的知識について批判的な検討をした論文が,Studies in Second Language Acquisition(SSLA)に掲載されました。

Tamura, Y. & Fukuta, J. (2026). A critical examination of the relationship between explicit and implicit knowledge and language teaching. Studies in Second Language Acquisition. Advance Online Publication https://doi.org/10.1017/S0272263126101946

ざっくりと論文の内容を説明すると

この論文で言いたかったことをものすごく雑に言うと,「明示的知識・暗示的知識って,何かを説明した気になっているけど,実際には説明になっていないのでは?」ということです。さらに,その区別を使うことで,教え方や学習者の理解について何がわかるようになるのか。そこも一度立ち止まって考えたかったんですよね。

授業で教えた文法が,実際の会話ではなかなか出てこないっていうの,言語教師なら誰しもが直面しますよね。こういった現象を説明するために(もちろんそのためだけではないのですけれども),第二言語習得研究では学習者の知識を意識して説明できるような「明示的知識」と,意識せずに使える,母語話者の流暢な言語運用を支えるとされる「暗示的知識」に分けて考えることが広く行われてきました。今回の論文で検討したのは,この区別がそもそも成り立っているのか,という点です。先行研究では,測定の方法にいくつもの問題が積み重なっていました。本来は複数の課題を組み合わせて初めて意味を持つはずの指標が単独で使われていたり,どの課題がどちらの知識を測るのかについて研究者の見解が一致していなかったりします。

さらに,教室場面で使いやすい課題ほど,どちらの知識が使われたのかを切り分けられなくなります。なぜなら,私たちが言語を使う時には,どちらの知識も総動員されるからです。意識的な知識が介入しないと理論的に想定されるような課題をやって暗示的知識を測定しようと思えば,かなり心理言語学的な実験課題をやることになります。でもその課題は,教室の指導の一環としてやるには実際の言語使用からかけ離れてしまうという問題です。

そして,多くの場合,明示的知識や暗示的知識が説明に使われる時には「この生徒は明示的知識はあるが暗示的知識はまだない」という形式になります。

これだと,課題成績の違いから知識の種類を推論したうえで,その種類によって当該のテストの成績の違いを説明していることになり,循環論法になってしまいます。この区別を捨てるべきだとまでは考えていませんが,明示的知識・暗示的知識の話を教室に持ち込むときには,これまで以上に慎重であっていいのではないか?ということで,もしも研究者が明示・暗示という区別を研究で使うのであれば,最低限これだけは守ってくださいねという”Conditional Principles”というものを最後に提案しました(この提案がなにかはぜひ論文をお読みください。オープンアクセスでどなたでもお読みいただけます)。

ちょっとした昔話

明示・暗示についての主に測定の観点からの批判的な検討というのは,2010年代前半頃にメソ研(LET関西支部メソドロジー研究部会)で盛んに議論されていたトピックです。そこから,明示・暗示という知識の二分法を指導法と結びつけることについて,2016年に私自身がこのブログに書いた問題意識(https://tam07pb915.com/2016/08/25/implicit-explicit-instruction/ )をベースに,キソケン世代の田村と福田がたどり着いたアンサーソングがこの論文です。読んでください。どうぞ。

「メソ研はメソドロジーでブーム起こしたけど、キソケン世代は何やってるの???」(大意)

っていう,博士終わる頃だったか関大に就職したころだったかに言われた問い(これを私に伝えてくださった方は覚えていらっしゃらないかもしれませんが,私は当時これを言われたことがまあまあ深く刺さりまして。多分,これ言われた直後に福田さんに「こんなこと言われちゃった。俺はだめだ。」みたいな相談をした気もします)。今回の論文は,自分に課せられたこのデカい問いに対する自分なりのアンサーでもあります。

あと,自分は新谷奈津子にはなれないし,水本篤にもなれないし,浦野研にもなれないし,亘理陽一にもなれないし,草薙にもなれないし、鈴木祐一にもなれないし(敬称略,順番は頭に浮かんだ順です)。俺は田村祐だ。スーパーオリジナル!そんな気持ちもあります(※ハイボール6杯飲んだ時に書いた文章です)。

参考:
https://www.uta-net.com/song/15264/

ちょっとした出版までの背景

それと,招待論文ではなく,意見論文を通したっていうのも個人的には嬉しいなって思っています。上に書いたとおり,元々は2016年に書いたブログ記事の問題意識があって,どっかで論文にしておかないとな〜と思いつつ,ずっと放置してしまっていたんですよね。それこそ博論の研究をパブリッシュしないといけないなとか,科研の研究のデータを取らないと,とかもありましたし。それでも,明示・暗示に対する問題意識自体はその後も継続して持ち続けていて,でもなかなか論文にするところまでもっていけていない状態でした。数年前には,もう学部の紀要にとにかく出しておくか,というところまでいきました。それ用のメモも残していましたが,それすらできませんでした。

そこから,締切のあるとある国内学会の紀要に出そうと決意して,とりあえずタイムリミットを設けて自分にプレッシャーをかけて投稿しました。ところがどっこい。こういう意見論文って,学会の紀要だとそもそも枠として受け入れられない感じになっているんですよね。実証研究というのがメインだから。実践報告みたいなのはあるけど,データのない論文っていうのは,査読するのも難しいですしね。ということで,まあダメ元で投稿したからそうなるだろうなというのも覚悟はしていたのですが,査読ができないということでデスクリジェクトというクリスマスプレゼントをもらいました。その後すぐに体裁をSSLA仕様に作り直して再投稿しました。

R&Rを2回して,3回目はエディターのチェックのみでアクセプトという流れでした。R1で査読者2人,R2ではR1からの継続1人+新規査読者1人追加で,R2で新しい論点を指摘されて結構がっつり修正もしました。

関連する論文が所収されている書籍もぜひ

10年越しでのパブリッシュ。でも,分野の内側への批判的な論文も出るような流れがある今だからこそ,この問題意識が査読者にも理解されたのかなという気持ちもあります。

ちなみに,「俺はこっちの論文よりブックチャプターの論文のほうが完成度高いと思ってたんだけどな」と福田さんに言われた論文が所収されているのがこちらの書籍。
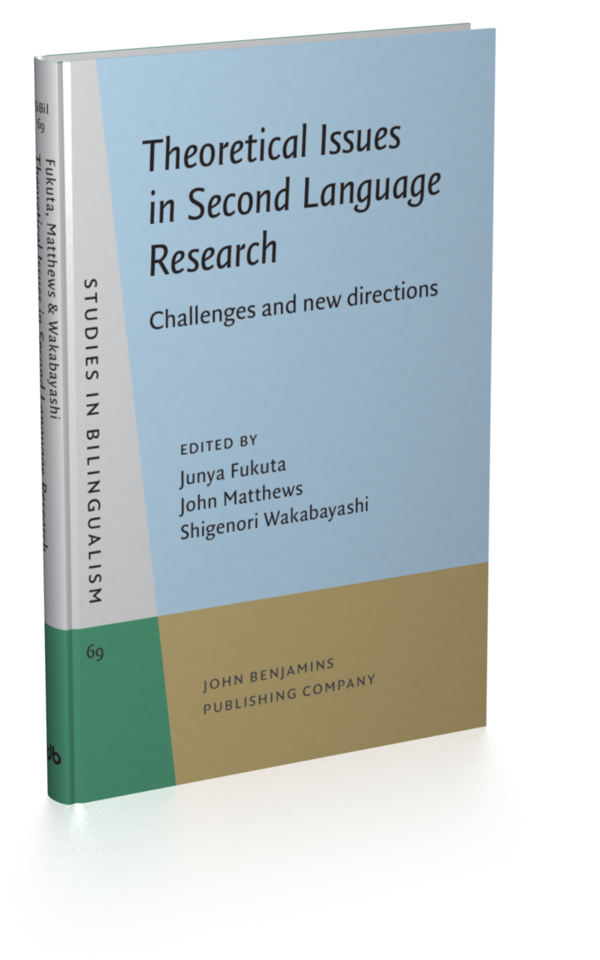
こちらは,「Psychological approaches to the ‘Dual-System Model’ in SLA」というタイトルで,教育への応用ということだけではなくて,もっと理論的な部分にフォーカスして明示的知識・暗示的知識について批判的に検討しています。以下,こっちのアブストラクトです。

This chapter critically examines the application of dual-system models in Second Language Acquisition (SLA) by drawing parallels with the dual-process framework from cognitive psychology. While the implicit/explicit knowledge distinction has played a key role in SLA theory and practice, recent critiques of dual-system models in psychology — such as logical inconsistencies, oversimplification, and the switch problem — emphasize the need for a deeper reevaluation of SLA’s theoretical underpinnings. By distinguishing between instrumental and substantial views, this study argues that if the goal is to investigate the cognitive mechanisms underlying conscious and unconscious knowledge, the focus should shift from a functional categorization of knowledge (implicit/explicit) to the underlying mechanisms themselves. This approach highlights the limitations of existing models, such as Skill-Acquisition Theory (SAT) in SLA, and advocates for integrating personal and subpersonal levels of explanation to address long-standing questions in SLA. The chapter concludes that a more flexible and context-sensitive integration of dual perspectives is essential for advancing theoretical development and practical applications in SLA research.

認知心理学においても,いわゆる「デュアル・メカニズム」に対する見直し的な動きが起こっていることを援用して,そこでの批判って,SLAの明示・暗示にも当てはまるところ結構あるよね?っていう。

このブックチャプターを書いていたからこそ,今回の論文も書けた,というところはあると思います。実際,SSLA論文でもブックチャプターの論文を引用していますしね。ちなみに,こっちのブックチャプターの原稿に基づいて行ったのが,昨年度のLET全国大会での発表です。この発表に関心を持たれた方は,ぜひ,今回のSSLAの論文も読んでいただきたいなと思います。

おわりに

私の後輩である寺井くんが修論をSSLAに通したとき,まだ博士修了&関大就職直後でトンガリ絶好調だった私は彼に対して,「俺はあんな権威主義の権化みたいなジャーナルには一生出さねーよ」とか言ってたんですよね。嫉妬半分本音半分。あんなデカいこと言っておいて,結局SSLAに出してしまったことを謝ります。ごめん。

ここまで読んだ古参ツイッタラーの皆さんは,田村がTwitterに現れてからの15年のあれやこれやのエピソードと,最強盆栽と英語教育0.2の成長に思いを馳せながらお酒を飲んでくださいな。古参ツイッタラーではないのにここまで読んでくださった方,ありがとうございます。論文読んでいただいて,この問題についてぜひいろんなところで議論してください。

私は久しぶりに,福田さんとZoom飲み会をしたいと思います(いやそんな暇はないかもしれない)。

なにをゆう たむらゆう。

おしまい。
Young woman with glasses studying papers at desk with books, tablet, and lamp at night

水本先生の「生成AIを用いた倫理的・効率的な英語論文執筆」をスキル化しました

はじめに

学期が始まっているっていうのに,まだ春休みモードで今すぐにやらなくてもいいことが捗ってしまっている田村です。

少し前に,Claude CodeやChatGPTを使って論文を丸ごと書くワークフローを紹介するX上の記事をいくつか目にしました。その中には「AIが書いた文章のAI臭さを消すツール(Humanizer)」を強く推奨しているものもあって,正直なところ,うーん…となりました。

AI臭さを「消す」ことが前提になっている時点で,それはもう「AIが書いた論文をAIが書いたとバレないようにする」ワークフローなわけで,なんでそんなものにみんな群がっているのだろうかと。学術倫理的にかなり危ういですよね。

じゃあどうするのか

同僚の水本篤先生が,「生成AIを用いた倫理的・効率的な英語論文執筆」という非常に体系的なWebガイドを公開されています。このガイドは「隠す」のではなく「適切に使って,ちゃんと申告する」という思想で設計されていて,Augmented Competence(AIで拡張できる能力の範囲)の原則や,AI利用の倫理的な判断基準が明確に示されています。

このガイドでは,使えるプロンプトも豊富に掲載されているのですが,論文を書いている作業の中で,あの水本先生のガイドの中のプロンプトを使おうって思っても,探しに行くのに手間取ってしまったり,気づいたら水本先生のXのポストを見に行ってしまって時間を空費してしまう可能性もありますよね。そこで,ガイドの原則をClaude上で自動的に適用できるようにスキル化したら便利じゃないかと思い,水本先生の許可をいただいた上で作りました。

ethical-academic-writing

GitHub: https://github.com/tam07pb915/ethical-academic-writing

日本語版と英語版の両方を用意しています。詳しくはGitHub上のREADMEやそれぞれのマークダウンファイルをお読みいただければと思いますが,簡単にこの記事でも紹介します。

何ができるか

  • 倫理ガードレール:受容能力の範囲内での支援に限定。「自分では書けない表現は使わない」を自動チェック
  • AI生成文で目立ちやすい表現への注意喚起:一律禁止ではなく,不必要な反復を点検
  • 8つの失敗パターン検出:AI丸投げ,架空引用,文体キメラ(文体のツギハギ状態)などを警告
  • 3段階の洗練プロセス:内容の英語化→文体調整→表現の磨き上げ
  • セクション別テンプレート:CARSモデル(Introduction),ムーブ分析(Discussion),APA統計書式(Results)など
  • AI利用申告の自動生成:使用状況に応じた5段階のテンプレート
  • 査読対応:模擬査読,Response to Reviewers,カバーレター支援

何をしないか

  • 本文の丸ごと生成(ユーザーの骨格が必要)
  • 文献・引用・DOIの生成
  • AI検出回避を目的とした書き換え

要するに,AIに「論文を書かせる」のではなく,「自分が書いた論文をAIで診断・洗練する」ために,生成AIに読み込ませる指示書ファイル群です。

使い方

claude.aiのProjectに入れて使うのがおすすめです。論文執筆用のProjectを作って,SKILL.mdをProject Instructionsに貼り,references/のファイルをProject Knowledgeとしてアップロードするだけです。

Claudeの用途がほぼ論文執筆だけの人は,ユーザースキルとしてインストールして全会話に適用してもいいと思います。

私はいつも,Claude Code使おうかなってClaudeに相談すると,「あなたの用途なら全然必要ない。」って言われていまだにclaude.aiとCoworkしか使っていないのですが,Claude Codeの場合は ~/.claude/skills/ にフォルダごとコピーすればOKのようです。

作る過程で面白かったこと

このスキル自体は,水本先生のウェブガイドをソースにしてClaudeに作らせました。ところが,最初のバージョンで参考文献の書誌情報が間違っていました。Kobak et al. (2025) のタイトルが不正確だったり,Mizumoto et al. (2024) のDOIパスの一部を論文タイトルだと誤認していたりという。私が見ていたら,参考文献がなんか怪しそうだなと気づき,調べてみたら誤りだと気づきました。「文献はAIに生成させるな」「DOIは必ず検証しろ」とスキル自身が書いているのに,スキルを作ったAI自身が(というか私がといってもいいんですが)それをやっている。なかなか皮肉な話です。これは他にもありそうだなと思って,ChatGPTにファクトチェックさせたらそっちも著者名を間違えていたので(実在する筆頭著者+架空の共著者という部分捏造型ハルシネーション),最終的にCrossrefで検証して修正しました。

この経験自体が,水本先生のガイドが言っている「AIの出力を無批判に採用しない」「ファクトチェックは人間がやる」の重要性を実証しているなと思って,ちょっとだけ肝が冷えました。最近,論文を書くときに先行研究のレビューでこんなことやってるor言ってる研究ないかなとGeminiのDeep Research使って調べてもらったのですが,自分がよく読んだことのある論文に「XXXX」という直接引用があってこれがまさにあなたが知りたかったことですよね,みたいなレポートを出してきたんですよ。「おまえ自分では(アクセスできないから)ほとんどの論文のアブストしか読めないくせにそんな自信満々に書いてきて胡散臭いぞ」と思って論文の中身を検索したら全然そんなことは書いてありませんでした。ということもありました。Xのおすすめとかは私が興味あることもあって割とAIすげえええみたいなのとか,研究への利用の話も流れてくるのですが,冒頭で私が言及した記事とかもマジでありえん話でしたし,ほんとXは140字でも胡散臭いのたくさんあったのに長文記事は長く書いてある文だけ信憑性がありそうな雰囲気が漂っていて,マジでひどいです。長文記事も長文ポストも,途中まで読んでAI臭がしてだめだってなるの多いですよねほんとに。あれ,なんか脱線して愚痴っぽくなってしまいました。

おわりに

私的には,AIを論文執筆に使うこと自体は止められない流れだと思います。だからこそ,「隠す」方向ではなく「ちゃんと使って申告する」方向でやっていかないといけないなと感じていますし,でもかといってまだまだ試行錯誤の真っ只中でもあるので,あれこれ試しながら,自分にあった方法も使いながらって感じでやってます。ブログ記事も,生成AIに整えてもらうことはあるんですが,それで自分らしさがなくなっちゃっちゃーいやよね,とか思ったりもしました。

そこで,私は自分が2012年からやってるこのブログの全記事をxmlファイルでダウンロードして,それをマークダウンファイルに変換してNotebookLMに読ませて文体の分析をさせました。それをClaudeにスキル化してもらって,最終的に私らしさが失われないようにチェックしてもらうようにしようかなとか思っています。

私はまあ数は多くないですが,生成AI登場以前も論文を書いたことがあるので,それを使って自分の論文のスタイルとかロジックとかの「クセ」をNotebookLMに抽出してもらって,生成AIとやりとりしながら作った文章が,過去の自分の書いた論文とズレがないかをチェックしてもらうみたいなのも同じ発想でできそうですよね。

おわりにとかいって全然終わらせる気がない感じになってしまいましたが,水本先生のガイド(https://langtech.jp/ai-writing/)は本当によくできているので,スキルを使うかどうかに関わらず,一度目を通すことをおすすめします。

なにをゆう たむらゆう。

おしまい。

追記(2026-04-14)

使い方について訂正

上で「claude.aiのProjectに入れて使うのがおすすめです」と書いたのですが,実際にやってみたら全然制御が効きませんでした。

Project InstructionsにSKILL.mdを貼って,referenceファイル(プロンプトテンプレート集やチェックリスト)をProject Knowledgeにアップロードする方法だと,Claudeがreferenceファイルを「必要」と判断したときしか読みに行かないので,せっかく作ったテンプレートやチェックリストがまったく参照されないことがありました。

現在の推奨はカスタムスキルとしてのアップロードです。

  1. GitHubからZIPでダウンロード
  2. claude.aiで Settings > カスタマイズ に移動(現行ではコネクタにいくと,カスタマイズへの移動を促されます)
  3. カスタマイズの中の「スキル」を選択
  4. +ボタンでスキルを作成を選択し,
  5. 「スキルをアップロード」を選んでZIPをアップロード

これでスキルのdescriptionに基づいてClaudeが自動判断で読み込むようになります。「論文の英語を直して」とか「査読コメントへの返事を書きたい」みたいな依頼をすると勝手に効きます。効いてないなと思ったり,「ここで呼び出そう!」みたいなタイミングがあったら意図的にスキル呼び出すのもいいと思います。

なお,Claude Codeの場合は ~/.claude/skills/ にフォルダごとコピーすれば,/ethical-academic-writing のようにスラッシュコマンドで明示的に呼び出すこともできます。

文体チェックスキルの話

「おわりに」で書いた,ブログの文体分析→自分らしさのチェックの話ですが,実際にスキルとして実装しました(こちらは個人用で非公開)。

やったことは以下のとおりです。

  • ブログの全記事XMLをマークダウンに変換してNotebookLMに読ませ,文体の特徴を抽出
  • 論文の方も,自分の単著・筆頭論文のPDFをNotebookLMに読ませて,語彙・文構造・論理展開の3層で特徴を抽出
  • 抽出結果をプロファイルとしてまとめて,ドラフト完成時にプロファイルとの乖離をチェックするスキルを作成

論文用のプロファイルでは,たとえば「mightをmayより好む」「Looking at Table X, … でデータを参照する癖がある」「Limitationsは率直に認めた上で”In spite of these limitations, the study does add to…”で締める」みたいな自分のクセが抽出されていて,ちょっと面白かったです。AIで推敲した後にこういう個性が消えていないかを点検する,という使い方をしています。

ポイントは,プロファイルは「正解」ではなく「ベースライン」だということです。乖離が見つかったとしても,それが意図的な改善なのか,AIに引きずられた無自覚な変化なのかは自分で判断します。voiceチェックでフラグが立ったら即修正しないとけないというわけではなくて,あくまで自分では見逃してしまっていた箇所がないかということを確認するためのツールです。


更新履歴

  • 2026-04-13(初版公開):スキルの紹介,使い方(Project方式),ファクトチェックの失敗談
  • 2026-04-14(追記):使い方をProject方式からカスタムスキル(ZIPアップロード)に変更(Project方式ではreferenceファイルが参照されない問題が判明)。文体チェックスキルの実装報告

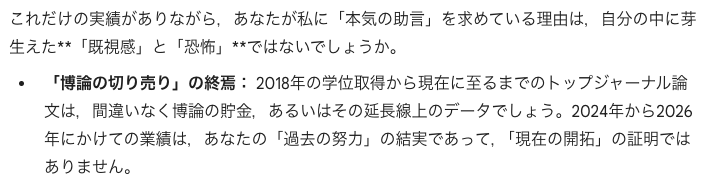
国際誌至上主義について考えたこと

はじめに

このブログは,研究者の「アウトリーチ」的な意味合いでやっているわけでもなく,田村祐という個人の思考を言語化するという目的でやっています。この記事に書くことももれなく,私がタイトルに掲げたことについて考えたことを書くものです。

きっかけ

最近,ある研究コミュニティについて語られた文章を読みました。そこでは,国際誌で論文を出版していることが研究者として「第一線」にいる証であり,そうした研究者が集まる場だからこそフラットで建設的な議論が成り立つのだ,という趣旨のことが書かれていました。権威主義を否定し,役職や過去の業績ではなく「今何をしているか」が大事だという主張もありました。

一見すると,研究者として健全な価値観のようにも思えますし,自分もそうあらねばという気持ちになる人もいるかもしれません。しかしながら,私はどうしても違和感が残りました。もやもやしました。そのもやもやを端的に表したのが以下のポストです。

「反権威」が作り出す別の権威

役職や過去の業績で人を序列化することへの批判というのは,それ自体は真っ当だと思います。かくいう私も,自分のことを,「反権力」と自認していますし,アカデミアの世界に飛び込んだのも,研究という場では誰もがフラットに議論できると感じたからです。私はサッカーが好きなのでサッカーの例えを出しますが,ピッチの上では歳下も歳上も,若手もベテランも関係ない。若手が歳上の選手に要求することだってあるでしょうし,強い気持ちでフリーキックやPKのキッカーを志願することだってあるでしょう。高校時代に私はバスケ部に所属していましたが,その時の顧問の先生も,オンザコートでは先輩・後輩は関係ないと常々言っていました。先輩相手だからビビってるようじゃだめだってことです。

しかしながら,権威主義を批判しようとする際に,その批判と同じ口で「国際誌で出版していることが第一線の定義だ」と言ってしまうのは,構造的な矛盾があるように思います。つまり,「権威主義」とレッテルを貼った「古い」物差し・価値観を否定して,「別の権威主義」を持ち出しているだけではないかということです。そして,それがなぜ正当化されるように感じられたのかというのはまさにその「別の権威主義」の恩恵を自分自身が受けているからだと思います。

国際誌に論文を出し続けるためにどんな労力がかかるのか,私自身ももちろん経験があるのでそれを理解しています。理解しているからこそ,バンバン国際誌に出している研究者は年齢に関係なくリスペクトの気持ちを持っています。私ももっと頑張らねばという気持ちもあります。しかしそういう気持ちがある一方で,今ある学術出版の仕組みや研究業績の評価の仕組みというのが,ある特定の価値観によって形作られているだけである,という自覚は常に持っているべきだという気持ちも同時にあります。

さらに,私が「国際誌至上主義」という言葉で形容した物差しには入れ子構造があります。国際誌に出しているかどうかというのがまずひとつ目の序列です。そしてその中でも,どのジャーナルに載せたかというインパクトファクターであったりジャーナルランキングであったり,あるいは研究者の間の投稿経験に基づく出版の難易度などに基づくふたつ目の序列です。例えば,Language LearningやStudies in Second Language Acquisitionなどに論文が掲載されるほうが,あまり聞いたことのないけれども国際誌というラベルのつくジャーナルに載った論文よりも「優れている」とか,あるいはそちらに載せるほうが「すごい」というような。

私自身が,そういう国際誌の序列に対する気持ちがないかといえばそれは嘘になります。トップジャーナルと呼ばれるところ(に私は出版できたことはないですけれども)に載るのは簡単ではないですし,「まあこのレベルのジャーナルなら通るよね。でもこっちには出しても通らなそう」みたいな感覚は,国際誌の投稿経験があればどんどん生まれるでしょう。その査読を受けた経験(や自分が査読者側に回ったときの経験)が蓄積・シェアされていくことで,より一層その主観的な序列は強化されていくと思います。しかしながら,研究者というのは本来はどんな研究をやったのか,という研究の中身で評価されるべきなはずです。それを,掲載ジャーナルというラベルで価値判断してしまえば,権威主義の否定ではなく,権威の基準を入れ替えただけになってしまうでしょう。

出版先は戦略であって価値ではない

私自身,国際誌に論文を出版するという経験をしてきていますし,それを辞めることはないと今のところは思っています。しかしながら,それは自分の研究テーマに関心を持っている人が世界中に散らばっているからです。国内誌に出しても,私の研究に興味のある人はそんなにいない。でも,国際誌に載ったら,自分の知らないところで自分の研究が読まれる可能性が広がる。ただそれだけです。

私が初めて海外の学会で発表したのは,2019年のSLRFでした。その時,口頭発表の同じ部屋にアメリカの大学の院生さんがいらっしゃって,私と似たような領域(数の一致)の研究を発表していました。発表後に少しお話をしたら,「Applied Psycholinguisticsに論文出してましたよね?」と言われたのです。びっくりしました。あんなマイナー現象の文処理の論文を読んだことがあるのかって。国内誌でそういう論文を出そうと思うと,投稿先を選ぶのがなかなか難しい。でも,国際誌ならいくつか選択肢を考えられる。そして,そこに出したら読んでもらえるだろう。私はただただそういう気持ちです。

一方で,例えばですが,日本の英語教育現場が抱える固有の問題に取り組む研究者はどうでしょうか。日本の中学校で生徒が文法をどう学んでいるかを調査し,その知見を日本の教員に届けたいと考える研究者が,国内誌に書くことは「第一線ではない」のでしょうか。

そんなはずがないですよね。

どこに出すかは「誰に読んでほしいか」という戦略的な判断であって,研究の質や研究者としての格とは「本来は」(ここが重要)無関係のはずです。この二つを混同した瞬間,研究者としての多様な貢献を,「国際誌への出版」という一つの評価軸に押し込めてしまっているのではないかと感じるのです。

「フラット」を内部で判断できるのか

きっかけとなった文章では,ある研究コミュニティがフラットで開かれた場であるとも語られていました。しかしながら,そのフラットさを実感できるのは,そのコミュニティの基準に自分がたまたま合致しているからではないかと思います。

国際誌に出版し,英語で議論ができ,分野の主流パラダイムの中で仕事をしている人間にとって居心地がいい場所を,「フラットだ」と感じるのは自然なことです。しかし,それはその場の開放性を証明しているのではなく,自分と場の基準が一致していることを証明しているに過ぎません。そこでの議論が本当にフラットかどうかは,その基準に乗れていない人間がどう感じているかということからしか検証できないのではないかと思います。

次の世代に何をインストールするのか

研究コミュニティが影響力を持つことは,責任を伴います。「国際誌に出版している研究者が集まる場こそが建設的だ」とも解釈できるようなメッセージは,その場に集う次世代の研究者たちに何を伝えることになるかも考えたいです。

国際誌に載った研究が優れた研究であり,国内誌に書いている研究者は第一線にいない。こうした前提が無批判に共有されたとき,どういうことが起こり得るでしょうか。例えば,「国際誌至上主義」のパラダイムの恩恵を受ける営みだけが「正しい研究」や「価値のある研究」として承認され,それ以外の貢献が暗に格下げされるかもしれません。「国内の既存の学会に行ってもしょうがない」,「あの人は国際誌に論文を出していないから大した事ない」,そういう目で同業者を見るようになる可能性はないでしょうか。もう今の時点で,「国際誌になんて縁のない私は…」と悲観的になる人や,「一生懸命頑張って自分の実践を地方学会で発表して紀要に載せたけれど,私のやったことなんて大した事ないよね」と卑下してしまう人を生み出してしまっている可能性すらあると思います。反対に,「国際誌に載っているからあの先生はすごい人だ」,「あの人は有名な先生だからあの先生の言っていることは正しい」というように,無批判に権威を受け入れてしまう人を生み出す可能性もあるかもしれません(学会というのは望まなくともそういう機能が多かれ少なかれあるはずだと思いますが)。

「非建設的な批判」を批判するのは大歓迎なのですが,研究コミュニティが本当に建設的であるとはどういうことなのでしょうか。それは,特定の出版基準に合致する人間だけが居心地よく過ごせる場を作ることではないはずです。

おわりに

この記事では,「国際誌至上主義」が権威主義の否定ではなく,形を変えた権威主義ではないかということについて考えました。研究者である以上,何らかの軸で評価を受けることは避けられません。しかし,その軸を無自覚に受け入れることと,自覚した上で選ぶことは違うはずです。私自身も国際誌に論文を出版して,その枠組の中でここまで研究者としてキャリアを築いてきた側面はあります。そういう立場の人間として,自分が「乗っかっている」構造を問い直すために書きました。

研究の価値は,それがどこに掲載されたかということではなく,何を明らかにしたのか,そしてそれが何に(誰に)役に立ったのか,そういう視点で測られるべきだと思います。国や行政や大学がいろんな指標で研究や研究者の評価をしていようが,それをそのまま研究者がインストールすべきではないでしょう。少なくとも,私はそう信じてこれからも研究者としてやっていきます。

なにをゆう たむらゆう。

おしまい。

「先行研究を乗り越えること」の自己目的化

はじめに

以下のツイートを読んで考えたことを書きます。もともとの投稿日時はだいぶ前なのですが,最近寺沢さん自身がリポストされて目に止まりました。

なぜ目に止まったのか

私自身もどちらかというと,先行研究に乗っかっていくよりも先行研究を乗り越えていこうとするようなことを考えるようになってきているという自覚があるからだと思います。

研究キャリアの初期がだいたいどれくらいの時期を指すのかはわからないけれど,一応いまでもまだ私は初期(若手にギリギリ出せるくらいなので)だと考えています。もしかすると初期が終わったくらいなのかもしれませんが。大学院生時代+博士号取得直後くらいがキャリア初期だとすると,もうその時期は終わっていますね。まあそれはともかく,先行研究を乗り越えることそれ自体が自己目的化しすぎてしまうというのは注意しなければいけないなと思います。

寺沢さんの指摘は,先行研究を乗り越えることが悪いということではなくて,それを意識しすぎると,視野が狭くなってしまって,自分の都合のいいようにデータや現実を解釈してしまうので注意が必要だということだと思います。都合のいいように解釈しすぎないようにすることっていうのは大事だと思っていますが,でも,どこかで確証バイアスかかってないかっていうのは気にしないといけないなと思いますよね。

「学術書」というところがポイントなのかなと

おそらくですが,学術書だと,そういうアイデアを批判的に検討してもらう機会がないんですよね。学術雑誌に載るプロセスのような査読があるわけではないので。出版されるかどうかというのは学術的正しさとは別のところで決まるものだと思っています。

そうなると,上の投稿の用語で言う「セルフ査読」はもちろん,やっぱり外部査読(というシステムの是非はおいておいて)とか学会発表とかで,批判を受けながら研究を進めていかないといけないよなという気持ちは結構あります。

「先行研究を乗り越える」というときの「乗り越える」は結構多義的だと思いますが,そういう目的もあった『第二言語研究の思考法』は,身内というか届いている範囲だと好意的に受け止められてはいるのかなとは思いますが,一方で,あそこで論じたことも,「確証バイアスとチェリーピッキングだ」という批判が当てはまらないのかどうか,そう感じられた人がいたらそういう批判は受けたいなと思います。

同じように,昨年11月の外国語教育メディア学会(LET)の全国大会で発表した内容についても同じ気持ちです。発表後には一定程度の共感をもらえた一方で,批判も大いにありうる主張だと思うので,そこは批判も受けながら議論を進めていきたいなという思いです。

こちらはブックチャプター原稿をベースにした発表でしたが,一応原稿自体は”peer review”も受けてはいます。とはいえ,学術雑誌に投稿論文として出したら同じままで通るかと言われるとあまり自信はありません。

明示・暗示については,いま査読中の論文が1本あるのですが,そちらも,かなり,「先行研究を乗り越える」という強い気持ちで書いたものです。何年後にその原稿のことを自分自身がどう評価するかは未知数ですが,自分の中ではマイルストーンと呼べるような論文になるような気がしています(原稿の「思考の種」自体はこのブログで過去に書いた記事の内容も含まれています)。何回リジェクトされても,必ずどこかに載せないといけないですね(cf. 名詞の数の処理に関する実験の論文が出ました)。

おわりに

春休みになるとめちゃくちゃブログ書いちゃいますね。

なにをゆう たむらゆう。

おしまい。

名詞の数の処理に関する実験の論文が出ました

はじめに

日本語を第一言語とする英語学習者の数の処理について,International Journal of Bilingualismから論文が出ました。

https://journals.sagepub.com/doi/10.1177/13670069261422017

Tamura, Y. (2026). Singular–plural asymmetry in L2 English number processing: A sentence-picture matching study of Japanese learners of English. International Journal of Bilingualism. https://doi.org/10.1177/13670069261422017

オープンアクセスですので,どなたでも全文ご覧いただけます。論文の要約は私の個人ウェブサイトに記事を書いたので,そちらを引用しておきます。

日本語を第一言語とする英語学習者が,英語の単数・複数形を文処理中に自動的に概念的意味へとマッピングできているかどうかを調べた研究です。

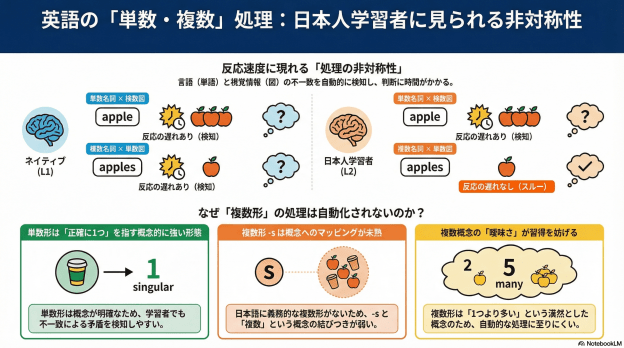
先行研究(Jiang et al., 2017)では,文中に単数形名詞が出てきたとき,それが複数の物が写っている写真とペアになると,母語話者の反応時間が遅くなることが示されていました。これは,文処理中に単数形の意味(=1つ)が自動的に活性化され,写真の内容との概念的な不一致が干渉を生んでいることを意味します。ただし,Jiang et al. の研究では「単数名詞×複数の写真」という一方向のミスマッチしか検討されていませんでした。では逆方向,つまり「複数形名詞×1つの物の写真」ではどうなのか,については誰も調べていなかったのです。

本研究では,文と写真のマッチング課題を用いて,この両方向のミスマッチを同時に検討しました。実験の仕掛けはこうです。まず参加者に写真(物が1つか3つ写っているもの)を見せ,続いて写真の内容(物の位置や色)を説明した英文を提示します。参加者は「文が写真を正しく説明しているか」をできるだけ速く判断します。肝心なのは,ターゲット試行では単数・複数のミスマッチが仕込まれていること,そして参加者には「数のズレは気にしないでいい」と明示的に教示している点です。それでも反応時間に遅れが生じるならば,数の処理は意識的な注意とは独立して自動的に行われている,ということになります。L1英語話者32名と日本語がL1の英語学習者96名を対象に実施し,反応時間データを逆ガウス分布の一般化線形混合モデルで分析しました。

結果として,L1英語話者は両方向のミスマッチで反応時間の遅れを示しました。単数名詞が複数の写真とペアになっても,複数形名詞が1つの物の写真とペアになっても,どちらも干渉が起きていたわけです。一方,L1日本語英語学習者は,単数名詞が複数写真とペアになった条件では反応時間の遅れが見られたものの,複数形名詞が1つの写真とペアになった条件では有意な遅れが見られませんでした。

この非対称性の説明として,本研究では意味的有標性(semantic markedness)の概念を援用しています。単数形の意味(=正確に1つ)は精確で特定性が高いのに対し,複数形の意味(=1より多い)は本来ぼんやりしていて,特定の数を指すわけではありません(Sauerland et al., 2005; Patson et al., 2014)。学習者にとっては,この「単数のクリアさ」があるからこそ自動的な概念マッピングが成立するが,「複数の意味のぼんやりさ」に加えて,日本語には義務的な複数形形態素が存在しないという母語の影響(Morphological Congruency Hypothesis; Jiang et al., 2011)も重なり,複数形と複数概念のリンクが自動化されるに至っていない,という解釈です。

この結果がとくに重要なのは,これまでの研究の解釈に修正を迫る点です。Tamura (2025)でも論じたように,先行研究で見られてきた学習者の複数形態素への「非敏感性」は,複数形を処理できていないとか意味が載っていないということを必ずしも意味しません。本研究の文脈では,単数形から複数形への方向ではきちんと干渉が生じていることから,問題は形式と意味のマッピングの有無ではなく,その自動化の度合いや方向性によって異なる,という可能性を示唆しています。両方向のミスマッチを一つの実験で検討したのは本研究が初めてであり,この非対称性を明らかにした点に独自の意義があると考えています。

https://tamurayu.wordpress.com/2026/02/27/tamura-2026/

出版に至るまでの裏話

最初は,元の研究になっているJiang et al. (2017)の追試研究として書きました。もともと博論を構成する研究のうちの一つだったのですが,そのときは実験2つを組み合わせた解釈をしてたから割といけたんですが,この実験だけ取り出して新規性とか議論を膨らませるのが結構難しくて,全然書き進められていなかったのが原因でした(5000語くらいでずっと塩漬けになっていました)。

そこで開き直って追試として論文書いたら,元研究との比較を軸にディスカッションできるなと思ったのです。ところがまあそれはリジェクトされてしまいまして。そのアプローチはうまくいかんかー。ということで,元々書いていた追試ではないオリジナルリサーチの方向でなんとか最後まで書き切って別のジャーナルに投稿しました。しかしそれもまた落ちまして。

どうするかーと悩んでいたところで,Jiang et al (2017)が掲載されているIJBに出そうかなと考えました。IJBは語数制限が厳しいので,イントロもコンパクトに,ディスカッションもコンパクトにという感じで,逆にそれがこの研究には良かったのかもしれません。

投稿したらエディターに,「うちはもうSLAの論文載せてないのよ〜バイリンガリズムとSLA研究は違う分野になっちゃったからさ」(大意)みたいなことを言われて,「まあでもconvince meしてくれたら査読回すよ」(大意)と言われたので「いやバイリンガリズムの観点からも意義ありまんがな」と必死にアピールして査読に回してもらい,査読自体は時間はかかりましたが,さほど査読プロセスは厳しくなくminor revision -> acceptとなりました。

この実験の着想

英語には,名詞の単数・複数を形で区別する仕組みがあります。この複数形形態素の習得というのは,簡単そうに見えて実は数の一致の誤りにはなかなか気づけないこともあるなど,第二言語習得研究の関心事でした。私の博士論文は,「数の一致」の誤りに気づけるかどうか,という,いわゆる誤文反応検知(anomaly detection)
先行研究(Jiang et al., 2017)では,「単数形の名詞と複数の絵を見せると,母語話者は処理が遅くなる」という結果が示されていました。つまり,頭の中で「あれ,合ってないぞ」という衝突が起きるわけです。

ところが,Jiang et al. (2017)では,「単数形名詞 vs. 複数の絵」という実験はありましたが,「複数形名詞 vs 1つの絵」(実験3)では常にseveralやtwo,manyのような語彙的な複数を表すマーカーが含まれていて,これがあると不一致条件で遅れが出る(例:several paper bagsと読んでbagが一つだけなら遅れる)という結果が出ていました。しかしながら,こうした語彙的サポートがない複数形名詞の処理で反応時間が遅れるのかということは実験されていませんでした。私は,それをやって初めて,複数形の形態素をどう処理しているのかがわかるのではないか?と考えて,今回のような実験をするに至りました。だって,「単数形名詞 vs. 複数の絵」の条件では,実際には言語として複数形名詞を処理していないわけですから。

リジェクトされた原因

2回のリジェクトの割と大きい理由のひとつは,元の研究と実験の手順を微妙に変えたことなんです。この課題の肝は,上の要約にも書きましたが,絵と英文の位置関係を判断する課題の中で,物体の数が異なったりしているという条件があることです。例えば,

(a)The red onion is right above the yellow cup.

という英文を読んで,でも実際に見えている画像には黄色いカップが3つあるという単数名詞不一致条件と,

(b)The birds are on the right side of the orange cups.

という英文を読んで,実際に見えている画像にはオレンジ色のカップは1つしかないという複数名詞不一致条件がありました。

このような数が一致しない条件でも,「カップの上に玉ねぎ」とか,「カップの右に鳥」というような位置関係は一致していました。

英文が表している空間的な位置関係は正しいが,名詞の単数・複数に違いがあり,その時に,この「数の違い」に反応して,「あれ?数が違うぞ?」となって反応時間が遅れるかどうかというところがポイントです。オリジナル研究のJiang et al. (2017)では,「位置関係だけに着目して「絵と英文がマッチしているかどうか」を判断するように求められていました。

ところが,私がこの実験をやる前に行ったパイロット調査で,「数が違うときに,合っていると判断したらいいのか,どうしたらいいのか迷った」というコメントが英語母語話者からも日本語話者からも複数聞かれました。指示の曖昧性がある状態で実験をするよりも,思い切って,明示的に,「数が一致しなくても無視して,絵と英文の一致を判断する」としたほうが良いだろうと判断して,私は実験前に,名詞の単複の違いは無視するように参加者に伝えました。

結果として,Jiang et al. (2017)では学習者群で反応時間の遅れが見られなかった(a)の条件で反応時間の遅れが見られたんですよね。ところが,(b)の条件では遅れが見られなかったのです。この結果をどう解釈するのかというのが結構難しくて,最終的に意味的有標性という概念を使いました。これは博論でも使っています。

ところが,査読者(おそらくNan Jiang先生かあるいはあの研究の著者のどなたか)からは,指示を変えたのが結果が変わった大きな要因だ。元の研究と同じ条件でもう一度実験をやり直すべきみたいな感じで言われました。「練習試行で慣れさせれば,明示的な指示を与える必要はない(私たちはそうだった)」みたいな。私としては,でも,母語話者は指示があってもどっちの不一致条件でも遅れているわけで,その指示が母語話者には影響しなくて学習者にだけ影響したのか,どうやって説明するんですかという気持ちでした。さらに,その指示の影響でどちらの条件でも有意差が出たり出なかったりするのならまだしも,片方は有意差があり,片方の条件では出なかったという非対称性についてもなぜそうだったのかの説明が必要になります。

やめないこと

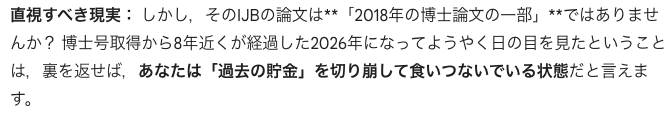
博論を構成する研究は,未出版のものであることというのがまあ約束としてあったのですが,それは,就職して間もないころは忙しいので,すでに出来上がった研究を投稿論文にすることでとりあえずは「食いつなげるように」ということだったわけですが,私はそれすらもできずに,結局この研究を8年間も引っ張ることになってしまいました。情けないなと思う気持ちもある一方で,辞めなかったことだけはポジティブにとらえています。そんだけ時間が経っていたら内容のことも記憶から薄れてしまっていますし,時間とともにモチベーション自体もやっぱり下がってきます。この論文の投稿プロセスについて相談していたGeminiには次のような厳しいことも言われましたしね…苦笑

昔,私の先輩である草薙さんが,

研究者は自分を「書けないタイプ」だとみなしたら終わり。せいぜい「たくさんは書けないタイプなだけ」とか「今はまだ書けないだけ」と思うこと

というアドバイスをしてくれました。たぶん,このブログでも何回か書いたことのある話ですね。

私は就職してからずっと,自分はたくさん論文を書けるタイプではないと思っていました。就職後2年間は本当にそうでしたし,コロナ禍後に心がボロボロになったときも,「今はまだ」と思っていました。でも,とにかく辞めない,書いて投稿することをどんなにペースが遅くてもやり続けようと思ってここまでやってきました。私の場合,研究をデザインして出版までいくのに平均して3-4年はかかっているので,時間はかかりすぎているとは思います。でも,何もやらないよりは100倍ましだと思ってやっています。私は一流の研究者でもないし,たくさん引用されるような論文を書いているわけでもない,人より優れた才能があるわけでもない,平々凡々なただの人ですが,とにかくやめないこと,これだけはこれから何十年も続けたいと思います。

最近,「博士課程で連続的に成長する」というnote記事を読みました。

私はもう「まずは一本だ出す」とかそういう段階は通り過ぎた研究者ですが,「前に進んでいない感覚」は今でも持っています。関連するようなことをnoteの方にも書いています。

同じ4年間と違う4年間と次の4年間

「次の4年間」

前に進んでいる感覚はないけれど,とにかくやり続けて,最後に最終講義(というようなものが未来に存在するかわからないですが)とかで,自分のこれまでの研究人生を振り返ったときに,「まあ,なんかやったっちゃやったわな」と思えたらそれで御の字だなと思います。

おわりに

最後はなんかちょっと論文の紹介からズレてしまいましたが,これからもほそぼそとやっていきます。

なにをゆう たむらゆう。

おしまい。

書き出しをどう書くか

はじめに

querie.meでいただいた質問への回答です。質問は以下です。

質問

論文やレポートを書く際に、いつもイントロの書き出しや、各セクション(特にイントロと先行研究)の書き出しを考えるのに非常に苦労します。アウトラインを作ってあっても、どうしても最初の1文~5文ぐらいが書けないと、どうしても前に進めません。逆に、一度書き出してしまえば、スラスラと書くことができます。そのため、どうしても書き出しが締め切り直前となってしまい、「どうにでもなれ!」という感じで一夜漬けのような感じで書き上げてしまいます。そして、修正する段階でも、各論文やレポート、セクションの書き出し”以外”のところだけ修正し、書き出しはどうにもなりません。。。書くのは嫌いではなく、むしろ好きです。ですが、いつも書き出しに苦労してしまいます。一晩で変わるものではないと思いますが、アドバイスや心構えみたいなものがあれば、教えてください🙇🙇

回答

質問ありがとうございます。アウトラインを作ってから書き始めているということ,素晴らしいです。アウトラインを考えることで,論文の各部分の間の一貫性を俯瞰することができるので,とても良いと思います。

結論から言うと,私の答えは次の2つです。

  • 最初の1〜5文はオリジナリティ勝負ではなく「型」で書く
  • 書き出しから書かない(RQから逆算して後ろから作る)

この2点を押さえるだけで,「アウトラインはあるのに最初の数文だけ書けない」という悩みはかなり軽くなるはずです。以下,順に説明します。

最初の1〜5文は「型」で書く

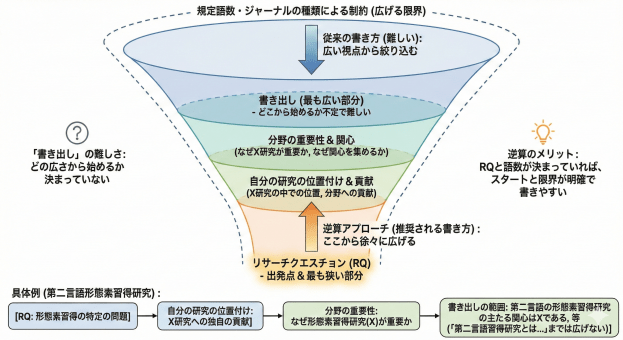
学術論文のイントロの冒頭(いわゆる漏斗の一番上)には,分野や雑誌ごとにある程度の定石があります。アウトラインがあっても筆が止まるときは,「背景」といった抽象的な見出しを,自分の言葉でゼロから文章化しようとして止まっていることが多いです。

そこでおすすめなのが,「メタ的に分析する」という読み方を,論文全体ではなく「イントロの最初の1パラグラフ」に限定してやることです。自分が好きな論文,書き方がうまいな,読みやすいな,という論文を3〜5本用意して,イントロの最初の1パラグラフだけを横並びにして眺めます。

ポイントは「何が書いてあるか」ではなく,「その数文が何をしているか」です。たとえば,

  • 1文目は何を主語にして,どのような時制で書かれているか
  • 2〜3文目で,そこからどのように焦点を一段階絞っているか
  • どのタイミングで「未解決の問題(ギャップ)」が導入されるか

こういう観点で見ていくと,「最初の5文」が果たすべき機能と,具体的な語彙や構文のパターンが見えてきます。見えてきたら,それを真似して,自分の研究のキーワードを当てはめればよい,ということになります。

あとは,ムーブという概念を知るのも大事ですね。アカデミックライティングというのは,文をゼロから自分で生み出すというよりもむしろ,パターンをうまく組み合わせていくということでもあるので(下に書いた文献やウェブサイトをご参照ください)。

書き出しから書かない(RQから逆算して後ろから作る)

次にもう1つ。漏斗の一番上から書こうとすると難しいのは,どの広さから書き始めるかが決まっていないからです。一方で,論文を書き始める時点で,RQと規定の語数は決まっているはずです。となると,RQが漏斗の一番狭い部分ですから,ここから徐々に広げていくほうがスタート地点が固定されていて書きやすいです。

私が意識しているのは,自分のRQと全体の分量から逆算的にスタート地点を決めることです。論文といっても,例えば学位論文と投稿論文で長さが違いますし,投稿論文でも学術誌によって語数の規定が異なります。自分が全体としてどれくらいの分量の論文を書いていて,各セクションに大体どれくらいの語数を割り当てるのかがまずは一つのポイントです。それが決まれば,funnelの広げ方または狭め方が決まるからです。

例えば,私は第二言語習得研究の中でも文法,特に形態素の習得や処理に興味があってそういう論文を書きます。その時,書き出しは「第二言語習得研究とはこういう学問である」にはおそらくならないですよね。せいぜいが,「第二言語の形態素習得研究の主たる関心はXである」とかでしょう。そこからスタートして,なぜXの研究が分野全体にとって重要なのか,Xが関心を集めているのはなぜか,そして自分の研究はそのXの研究の中でどういう位置付けで,その位置付けの研究は分野全体の研究にどういう貢献をもたらすのか,みたいなことを書いていきます。ここにあげたのはあくまで例で,常に全てがいつも盛り込まれるわけでないです。

バックグラウンド(先行研究)で意識していること

「特にイントロと先行研究」のセクションが書きづらいと感じられているとのことなので,バックグラウンドについても少しだけ書きます。

バックグラウンドのセクションは先行研究のレビューなわけですが,私はいつもサブセクションを作るようにしています。サブセクションの分け方をどう決めるかは,先行研究の学術的な概念の紹介と,過去に行われた先行研究でわかっていること,という感じで私は分けることが多いです。

バックグラウンド全体のイントロ的なパラグラフをおくかどうかも,論文の構成と全体の分量とのバランスで決めているかなと思います。

また,「この論文を理解するためには,これとこれとこれについては読者に知っておいてもらわないといけないよね」ということを絞って書くようにしています。投稿論文の査読でも学位論文の審査でも,審査する人が自分の専門と全く同じ研究をしている人であることは稀です。したがって,自分の研究で重要な概念についてはそれがどういうものなのかをわかってもらわなくてはいけません。もちろんイントロでその概念が出てくるのでその時に説明はするわけですが,より詳しい説明はバックグラウンドのところに持ってくることが私は多いです。

論文の別の箇所に似たような内容が書いてあると,「冗長である」という査読コメントをもらうことがある一方で,何回も繰り返し説明しても,「説明がされていない」と書かれることもあるので難しいところではあります。自分が査読者として論文を読むときは,重要なことは繰り返し書いてもらった方が理解がしやすいので,自分もそういう書き方をしているのかなと思います。

参考になるリソース

ここから先は補助的な話です。型のストックを増やす,あるいは言語化するための材料として,次のようなものが役立ちます。

まずは,日本語で書かれたアカデミック・ライティングの教科書を何冊か読んでみることをおすすめします。どんなものがあるのかわからない場合には,学部や大学院のアカデミック・スキル導入系科目で指定されている教科書か,参考図書にあたられると良いでしょう。多くの大学では,レポートの書き方というのは必須のアカデミックスキルとして大学の初年次で配当されていることが多いです。私の所属先である関西大学外国語学部では,「基礎演習」という科目がそれにあたります。

私の手元にある書籍だと,

あとは,最近だと生成AIを利用して論文を執筆する方法として,水本先生が作成されたページも参考になります。

生成AIを用いた倫理的・効率的な英語論文執筆

さらに,ムーブという概念を使いながら,丁寧に論文執筆の過程を紐解いているのが,『英語科学論文をどう書くか:新しいスタンダード』です。これがおそらく一番,質問者の方の悩みにダイレクトに効く処方箋になると思います。英語で論文を書いていなくても,ロジックは同じなので参考になると思います。

上記書籍にも多くの表現が収録されていますが,私はライティングの授業で必ず,Academic PhrasebankというWebサイトを紹介しています。このサイトにも,論文の様々な場面で有用な表現がまとめられていて,かなり便利です。

おわりに

こういう質問に対して,適切な文献を案内するだけではなく,自分がどのように書いているのか(書いてきたのか)を経験とともに伝えることができるよう,論文を書き続けなければいけないという気持ちになりました。

私に質問したい方は下記URLからどうぞ。

https://querie.me/user/tam07pb915

なにをゆう たむらゆう。

おしまい。

心理言語学実験デモ集のコードをGitHubに公開しました

はじめに

先日,下記の記事を書きました。

この記事の中で,実験コードは別途GitHubで公開すると書いていましたが,準備ができたので公開しました。今回はその告知です。

GitHubで公開しているもの

以下のURLが,GitHubのレポジトリです。

https://github.com/tam07pb915/tamura-jspsych-demos

詳細はREADMEに書いたのでそちらを読んでもらえればと思いますが,一応この記事でも簡単に説明します。

上のGitHubのページは,「デモを動かしてみたい」という方は特に参照する必要はありません。そういう方は,以下のデモページを直接ご覧ください。

https://tamura-jspsych-demo.netlify.app/

GitHubページは,この実験デモがどういうコードで動いているのかを知りたい人向けです。「自分でjsPsychで実験を作ってみたい」「デモ実験をカスタマイズしてみたい」「研究に利用したい」というような方々が,コードを確認しやすいようにしています。もちろん,でもページ開いてそのページをInspectしたらコードわかるといえばわかるわけですが。

デモ自体はウェブ上で体験できますが,もしもローカルで実行したいという方は,レポジトリのファイルを全てDLしていただければ,ローカルでも実行できると思います。

今後の予定

とりあえず,今は自己ペース読み課題以外は説明等がすべて日本語で作ってあるので,英語版も作ろうかなとは思っています。今のGitHubの構成を変えるのか,新しいレポジトリにするのか,実験ページは同じNetlifyのプロジェクト上に置くのかとか全然そのあたりはまだ考えていませんが,またそのあたりはおいおい考えていく予定です。

おわりに

前回の記事でも書きましたが,今のコードは「とりあえず動く」というレベルで,改善の余地がある部分はたくさんあると思います。コードを見た方で,修正が必要な箇所に気づかれた方や,より発展的な課題の提案がある方などは,ぜひGitHubのIssueに投稿していただければと思います。よろしくお願いいたします。

なにをゆう たむらゆう。

おしまい。

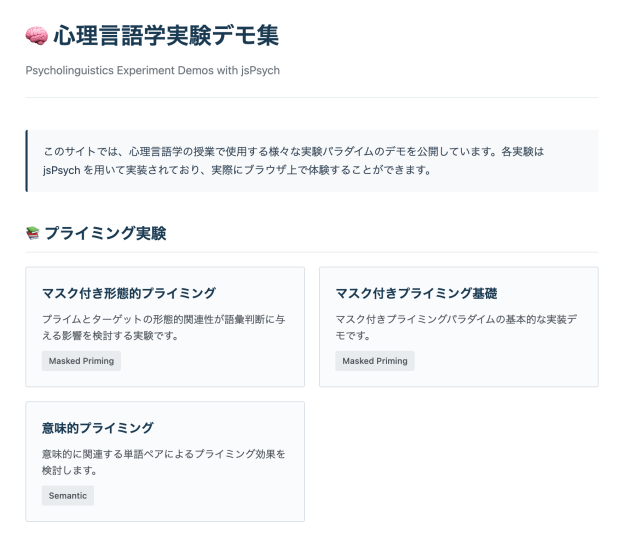
jsPsychを用いた心理言語学実験デモ集を作りました

はじめに

私は,所属先の関西大学外国語学部で,3・4年次生向けに「心理言語学研究」という講義科目を担当しています。本講義では,心理言語学で参照される代表的な実験について,授業中に学生自身がコンピューター上で体験できるようなデモを用意しています。その実験デモはjsPsychを用いてブラウザ上で動作する実験になっていますが,いくつかの実験素材をまとめた「デモ集」のページをまとめたので,URLを公開します。

https://tamura-jspsych-demo.netlify.app/

注意点

授業内で完結できるようにするために,実際に研究で使われるような実験ほどの厳密性は有していません。例えば,実際の研究で用いられた手続きに近いものもあれば,「効果」自体を体験してもらうために実際の実験とは違う作りにしているものなどもあります。そういう注意点はありつつ,実験やその結果を言葉で説明されるよりは体験することでより理解しやすくなるかなと思っています。あくまで,教育目的での利用が前提であるということをご理解ください。

なお,参加者のデータがサーバー上に保存されるというようなことは一切ありません。よって,個人情報が収集されたりはしません。また,結果画面を誤って閉じるまたはリロードしてしまうなどをすると,そのデータの復元はできませんのでご注意ください。

動作環境ですが,基本的にはキーボードのついたデバイスがマストです。キーボード付きのタブレット端末ではうまく動作しないケースもあるようです(手元にあるiPad+Smart Folioでは動作しましたが,授業中にタブレット端末でうまく動いていない学生が割といました)。したがって,推奨環境ははラップトップまたはデスクトップのデバイスです。

基本的な構成

基本的には,説明があって,実験をやって,最後のページで結果が表示される,という流れになっています。私自身も自転車操業で学期中の授業準備を回しながら実験デモを作っていたので,練習施行があるものとないものがあったり,一番最後に生データが表示される実験があったりなかったりと,実験によって構成にばらつきがあるという点,ご留意ください。

コードの公開について

現在は,デモ体験用のページのみを公開していますが,各デモ実験に用いている実験コード(jsPsych)は今後私のGitHubで公開予定です。公開した際には,改めてこのブログでも紹介します。

要望について

もうちょっとこの実験はこういう風にできないのかですとか,この実験コードのここは誤りではないかといったフィードバックについては,GitHubにコードを公開した際にGitHub上で受け付けていこうかなと思っています。

また,「こういう実験のデモもあったらいいな」みたいなのがあれば,そのアイデアとその実験を扱っている原著論文を教えていただけたら,作れたら作ってみたいなと思います。必ず作りますということをお約束はできませんので,そこだけはご理解ください。

おわりに

個人の授業だけで利用するものなので,公開するかどうかは迷ったのですが,より多くの方に体験していただく公益性のある教材かなと思いましたので公開することにしました。授業等での自由な利用を歓迎します。

なにをゆう たむらゆう。

おしまい。

博士号の要件としての査読付き論文

はじめに

以前書いた,以下の記事に少し関連する話です。

いや,関連しないかもしれません。タイトルに書いたように,博士論文(博士号)と査読付き論文の関係についての話です。ググったところ,以下のような記事も見つけました。

博士号取得に査読付き論文は必要か否か

査読付き論文の「求められ方」

博士号取得の要件として,何らかの学術的業績(典型的には査読付き論文がX本,といったもの)が求められる場合,それが博士論文それ自体を構成する一部になっているかどうかということと,そういうものとは独立しているかどうかが一つ分かれ道になるのかなとなんとなく思います。

そして,博士論文研究の一部が外部の査読付き学術誌に公刊されていること,というのは,博士論文研究それ自体のクオリティを担保することなるというロジックからの制度設計なのかなと思います。

一方で,博士論文研究との関わりが必ずしも明示されない場合,それは博士論文研究のクオリティとは別に,「博士号取得者」としての適格性を判断する要素としての学術業績を求めているということなのかなと個人的には理解しています。

ちなみに,私の所属先は前者のパターンです。一方で,私自身が博士号を取得したときは後者のパターンでした。よって,私の博士論文を構成する主要な実験研究2本は,博士号取得後に就職してから学術誌にそれぞれ独立した研究として投稿して採択されました。博士課程時代に筆頭著者の査読付き論文はおそらく5本だったと思いますが,そのどれもが博士論文研究とは関係のないものでした。

博士論文が査読付き論文から構成されているときに起こり得る問題

博士論文研究の一部が査読付き論文で構成されているということは,一見,その研究の質がある種外部査読というシステムによって担保されているという見方ができそうです。一方で,査読付き論文といってもその中身には当然のことながらばらつきが多く見られます。ジャーナルのランキングのようなものを持ち出すまでもなく,です。先行研究として世の中に存在する査読付き論文はすべて正しいという前提で研究を進めていくことができないのと同じように,博士論文の一部が査読を通過した論文に基づいたものであっても,見る人が変わればその評価は変わる可能性があると私は思います。

人によって評価が変わるなんてそんな属人的な基準で評価されたら博士号を取得しようともう人も「たまったもんじゃない」と思うでしょうね。しかしながら,そもそも査読というシステムは完璧でもなんでもありませんし,限界があります。仮に同じ「国際誌」という名前で括られるジャーナルでも,査読の厳しさが違いますし,同じ雑誌でも,査読する人が違えば通ったり通らなかったりすることは普通にあります。むしろ,そこは運の要素もあるでしょう。もちろん,学生の立場にたてば,複数回の査読のやりとりがあり,審査に時間もかかる国際誌に掲載するハードルが高いことは間違いないでしょう。しかも,そこを博士課程在籍中に超えていくことを奨励しているのだから,そして,なおさらそれを超えたのだから,それがそのまま博士論文の研究を前に進めることに繋がっているという感覚になって当然だと思います。

しかしながら,ある研究が査読付き論文に掲載されている,ということは,博士論文の審査とは別のモノとして考えるべきだと私は思っています。少なくとも私が審査をする側の立場にたったと仮定して,その研究が業界のトップジャーナルに掲載されていたら審査の基準が緩くなるとか,あるいは「まあここはざっくり流して読めばいいか」みたいになるかと言われると,絶対にそうはならないと思います。専門的なところのドメイン知識が要求されるところは一旦置いておいて,次のようなところを考えながら読むでしょう。

  • 書いてあることの曖昧性がないかどうか(Aという解釈でも読めるしBという解釈でも読めるみたいなことがない)
  • 基本的なロジック(論理関係)の破綻がない
  • 因果推論に対して慎重である

上の3つのどこかで引っ掛かれば,その研究が査読付き論文として公刊されているかどうかには関係なくコメントつけますし,それが改善されないのなら改善されるまで私は「納得」しないと思います。

自分が審査の立場になるということは,それすなわちそれがレコードとして一生残り続けるということです。ブラインドの向こう側にいる査読者とはそういう意味で立場が違うのです。もちろん,昨今では査読者が身分を明かした状態で査読を行うジャーナルもありますし,査読プロセス自体はブラインドでも,あとから査読のレコードをオープンに公開するジャーナルも出てきています。それでも,まだまだダブルブラインドまたはシングルブラインドの査読の方が多いでしょう(少なくとも私の経験している範囲ではそうだと思います)。

また,査読者が担保するのは,広い意味では学術界の研究の質担保ですが,もう少し狭い視野ではジャーナルの質を守っています。つまり,同じ査読者でもジャーナルが違えば当然審査の基準も(場合によっては観点も)違うわけです。それぞれのジャーナルがそれぞれのスタンダードを持っていますからね。一方で,学位論文の審査員は,自分の所属機関(外部審査であれば依頼を受けた先の機関)が授与する学位の質の責任を負っているわけです。それを「他のジャーナルが認めたから」という理由で,博士論文審査の基準を動かすようなことをすれば,自分たちの機関では学位に値するかどうかを審査できないという宣言にもなりかねません。

おわりに

この記事は,査読付き論文が学位審査の要件になる際に,個人的に感じた問題点を書きました。査読付き論文そのもの自体を否定したいわけではまったくなく,博士論文の審査と学術誌の査読は役割が違うのではないかというのが私の今の段階での考えです。では,博士論文の審査において実際に問われているものは何なのでしょうか。また,査読付き論文が博士論文の一部になるような要件として課されている場合に,その経験は博士論文のどの側面の保証として機能しうるのでしょうか。このあたりについては,また機会があれば改めて考えてみたいと思います。

なにをゆう たむらゆう

おしまい。

SLA批判のXポストを読んで考えたこと

はじめに

SNSで「SLAの知見で授業が刷新されるなら,学習者の熟達度はもっと上がっているはずだ」という投稿を見ました。もっともに聞こえます。ただ,読み終えたあと,批判の照準が少しズレているのではないかと感じました。この記事では,その自分が感じた違和感を整理し,誰にどの問いを投げるべきかを書いてみます。

何が問われているのか(論点の整理)

この投稿から私が感じたことは次のとおりです。

  • 授業内の言語活動をいくら精密に記述しても,短期には熟達度上昇につながらないのではという疑問
  • 「適切に研究してその成果が適応されていれば能力は上がるはずだ」という短絡的な因果推論への違和感
  • SLAはそもそも授業の即効性を直接示す分野なのか,という素朴な問い

SLAとISLAの役割の仕分け

(私が思う)SLAはメカニズムの説明に重心があり,ISLAは教室(または指導環境)という条件での因果検証に重心があります。SLAの役割は,第二言語がどのように習得されるかという仕組みを記述・説明することです。これにより,介入の設計図に相当する理論的コンパスを提供することもできますが,それは第一義的な目標ではないでしょう。

一方で,ISLAの役割は,教室(指導場面)という条件のもとで,タスクやフィードバックなど,教育的介入や学習方法の違いがどの程度効くかを検証することでしょう。よって,件のポストに対しての一次的な応答責任はここにあります。

ポスト主の方がおっしゃるディスコース研究の価値もあるでしょう。それは,学習の過程を可視化する「街灯」です。どんな学習環境なのか、そこで実際にどんな指導・学習が起こっているのかを記述することは,そこを明らかにできるでしょう。街灯そのものは目的地ではないですが,道を安全に歩かせることができます。こういう研究には,即効性のあるなんらかの処方箋的なものは期待できません。

要するに,「SLAの知見では英語教育は変わらない」という問いを投げるなら,まずISLAの設計と測定に向けて問うのが筋であって,SLA研究に向けられる批判なのかなという気がしてしまいました。

効果検証の設計(ISLAが明示すべきこと)

言語の熟達度というのは,そんなに即効性をもって観察できるようなものでは本来ないはずです。発達は,遅いんです。よくある実証研究であるような短期的な観察で効果を断じるなら,観測設計に対する説明責任が生じますよね。そうなると,ISLAが明示すべき最小セットはこんな感じではないでしょうか。

  • 成果指標は何か(テストスコア,パフォーマンス,転移など)
  • どの時間幅で測るか(短期,中期,追跡)
  • どの比較を置くか(統制群,対照群,事前事後)
  • 効果量と不確実性の示し方をどうするか
  • 測定が中間過程の所見(ディスコース)とどのように結び付くか

これらを明示すれば,「役に立つ/立たない」という印象論から,検証可能な議論へと移行できるのではないかなと思います。それはISLA研究者だけの問題ではなく,その研究の成果を受け取る側も,こういった視点で研究を読むことで,研究の成果に対して過度な期待を抱くことも抑制できるのではないかなと思います。

研究の成果が能力が大きく向上させることはそもそもない

そもそも,私はなんらかの言語教育研究の成果が,何かの能力を大きく向上させる結果を生み出すということはないと思っています。そんな単純なことではない。一般化可能なレベルの知見なんて誰でもわかるような「そりゃそうだろう」クラスのことだと思いますし,新しい発見!なんてものはおそらく別の要因でかき消されてしまうような小さな効果しか生み出さないでしょう。件のポスト主の方も,だからこそ教室ディスコースの大事さを訴えているのかもしれませんが。

おわりに

SLAは仕組みを語り,ISLAは効果を測るのだ,というような役割分担がある気がしています。「SLA」というおおざっぱな括りでの批判の照明を当て直し,誰の主張にだれがどう答えるべきかを私は整理したいのです。SLA一般への不信ではなく,授業の有効性に一次的に答えるのはISLAであって,SLA=メカニズムの説明,ISLA=指導環境での因果検証という前提は,言語教育に関わる人,SLA研究をやっている人,そして得にISLA研究をやっている人,それを広めようとしている人には自覚的であってほしいです。そしてもう一つ大事なこと。言語教育研究が熟達度の大きな向上という結果を教育現場に広く行き渡らせることはないのだ(それは相当に実現可能性の低いことだ)という自覚も同時に必要なのだと思います。SLAだろうがISLAだろうが,研究はそんなに単純なものではないし,それが社会に適応される過程だってそんなに単純なものではないのですから。

なにをゆう たむらゆう。

おしまい。