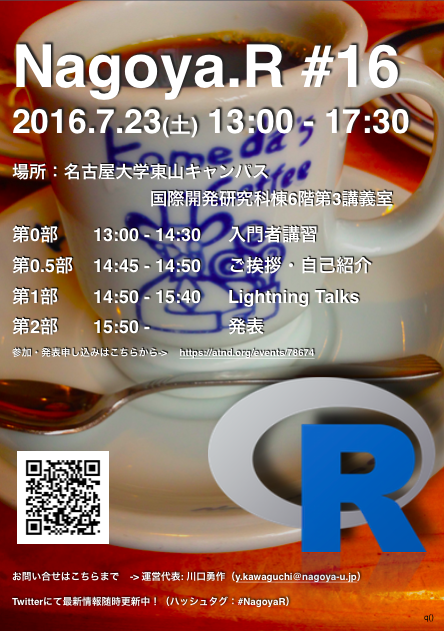
いよいよNagoya.R #16が明日となりました。飛び入り参加も大歓迎です。 https://atnd.org/events/78674

いよいよNagoya.R #16が明日となりました。飛び入り参加も大歓迎です。 https://atnd.org/events/78674
馬鹿じゃないのと思った。
今,とある原稿の執筆にあたって(〆切に間に合いそうになくてやばい),中学や高校の教科書のCAN-DOリスト,評価基準,年間指導計画なんかを見ている。そこで,とある教科書の(あえて名前は出さない)年間指導計画の,指導例というカラムに次のような記述があった。
3単現の-(e)sは理屈で覚えるよりも口をついて出るくらいまで文を言い,書く練習をする
まさに,「お前は何を言っているんだ」の気分である。そんな無駄なことをさせるくらいだったらもっといくらでもやること,やれることがあるだろう。これを書いた人は,自分が3単現の-sをまったく落とさない自信があるというのだろうか。3単現の-sは,超高熟達度の学習者でも習得が困難であると言われる文法項目の典型的な代表である。そして,文法的に主語をidentifyする機能はあるが,これがなくても文の理解に支障をきたすことはほとんどないと言っていい。なぜなら,英語は語順がわかれば主語が(ほとんどの場合)わかるからである。また,有生性も動作主-被動作主の関係を表すのに重要な手がかりとなる。3単現の-sが脱落していることが,意味理解を阻害することはほとんどない。過剰使用されている場合もそうだ(実は過剰使用の方が気づきやすいらしい)。
この「文を言い,書く練習をする」というのが,単なるパターンプラクティスのような物を意味していないのだとすれば,それに意味がないとは言わない。しかし,そうであったとしても,そのような活動は3単現の-sの習得を目指して行われるべきものではないだろう。誤解を恐れずに言えば,3単現の-sの習得など目指さなくても良い。それこそ,理屈を知っていて,ライティングの時などにモニタリングして直せれば良い程度のものではないか(それでも見逃すことだって私にはあるが)。3単現の-sが落ちていることにそんなに目くじら立てる必要はどこにあるのだろうかと思う。しかも,あろうことかそのどうでもいい形態素を習ったばかりの中学校1年生に対して,そんな無駄な苦行を強いるなんて言語道断である。もし本当に三単現の-sの習得を目指したいのであれば,それ以外のところにほとんど注意を向けなくとも書いたり話したりできるような訓練をした方がよっぽど良い。そういうことに時間を割いたほうが,全体としての英語力も上がるだろうし,結果的に3単現を落とすことも少なくはなるだろう(それでも母語話者レベルにはならないと思うが)。
私は英語の第二言語話者としてそれなりに機能できる自信があるし,相手の言っていることを理解したり,自分の気持ちや考えを伝えたりすることだってそれなりにはできると思っている(ただし,英語力に自信があるわけではない。語彙とかたぶん5000語くらいしかない)。英語を中学1年から勉強し始め,北米に2年間留学した私でさえ(むしろその程度だからこそ?),3単現はたまに落とす。英語教師として,正確無比な言語使用ができないことはプロとして恥じるべきだとは思うし,実際に毎週英語で授業をしながら「ヤベッ」と思うことがある。それはプロだからである。英語を教えることでお金をもらっているからである。プロを目指してもいない,英語学習を始めたばかりの中学生に(高校生や大学生だってそうだ),「口をついて出てくるまで」きっと無意味な文を言わせるなんて,そんな指導観を持っている人には絶対に教わりたくない。もちろん,そこまでして,情熱的に,なんとかして,英語を身につけさせてやりたいという熱意は素晴らしいと思う。しかしながら,圧倒的にベクトルが間違っている。その情熱はもっと別のところに注ぐべきだ。
余談だが,実はかくいう私も3単現の-sを減点したことがないかと言えば嘘になる。先日のテストのライティング問題である。語数,内容,文法・スペリングという3観点の評価方式を私はよく採用している。昨年度までは,このような形式を取る問題は1問だけで,ほかは文法の間違いは一切評価しない問題も出していた。今年は,そういう問題を出題できる環境でもないので,3観点方式のライティング問題だけを出した。そこで,私の担当しているクラスのうちの1つで,とびっきり出来の良い学生が,3単現の-sを落としたというだけで,99点を取った。私も採点しながら,本当に心苦しい気持ちになってしまった。途中まで採点していて,「これは満点だなぁ」と思っていた矢先,最後の最後のライティング問題で彼の「誤り」を見つけた時,この採点方式を取ったことを本当に後悔した。テストの他の大問も完璧で,ライティング自体もトピックに沿ってよく書けていた。そこにきて,3単現の-sがたった一箇所落ちていただけで,私は彼が満点を取ることを阻止してしまったのだ。そして,翌週テストを返却したとき,答案をみてその学生が言い放った一言を私は一生忘れることがないだろう。
「くだらねえ」
私はなにも言えなかった。そして,自分で問題を作っておきながら,私自身も「くだらねぇ」と思ってしまったのだ。大いに反省した。そして,今度の期末試験では,文法面に関しては「意味理解を阻害するかどうか」という観点で,おおまかにレベルを4段階設定し(Foster & Wigglesworth, 2016を参考にした),意味理解を阻害しない程度の誤りが少数見られる場合は,その観点では満点とすることにした。もちろん,このレベル分けや,誤りのレベルの頻度というやり方も完璧とは言えない。まず,「なにを持って意味理解を阻害しない」と考えるのかは非常に難しい問題である(もちろんいくつの誤りがあれば「少数」とするかも問題である)。意外なことに,第二言語習得研究の知見からこの観点に関して言えることはほとんどないと言っていい。「誤りの重み付け」に焦点をあてた前述のFosterらの研究が「新しい評価法考えたったー!!」と言ってAnnual Review of Applied Linguisticsの最新号に掲載されているくらいだから,本当に研究されてこなかったのだろう。博論が終わったらこういう問題に取り組みたいとは思っているが,誰か「面白そうだな」と思う方がいらっしゃったらどんどんやっていただきたい。というかむしろ誰かやってくださいという感じだ。
かなり脱線したが,3単現の-sは本当に厄介者である。というかむしろ,「数の一致 (number agreement)」という事象自体が実はかなりの厄介者なのである。結論を言うと,文法習得を専門に研究している私から言わせてもらえば
3単現の-sをなめんなよ
である。そして,文法の正確さばかりに目くじらを立てる英語教師(含む過去の自分)は全員引退した方がみんな幸せになると思う。
なにをゆう たむらゆう。
おしまい。
これは結構面白かった。選挙のときにgeneralに争点になる内容とは違って,自分の仕事に直接的に関わる政党のポジショニングや意見がわかったし,研究者の卵としてとてもありがたい試みだと思った。
数年前からEvernoteを愛用しています。使い方は多岐にわたっていて,単なるメモ書きだけにとどまらず,大事な書類をスキャンして放り込んだり,気になるウェブページをガンガンクリッピングしたりしています。研究のネタを書き留めたりもしますし,論文をいつどこに投稿するかの予定を書いておいたり,また実際に投稿した論文の審査過程をメモしてもいます。例えば,いつ投稿して,査読結果が来たのはいつで,修正原稿の〆切はいつで,手元に実物が届いたのはいつか,など。あとは,1度学会の年会費を払ったかどうかを確認できずに冷や汗かいたことがあるので,最近は振り込んだらその領収書をEvernoteに保存するようにしています。こういう小さい紙をスキャンするのに便利なのが,scannableというアプリで、かなり気に入っています。このアプリで書類や領収書などの写真を撮れば自動的にPDF化してくれて,そのままEvernoteに保存することができます(写真として保存することもできます)。scansnapがあれば必要ないかもしれませんが,いつでも気づいたときにパシャりとできて便利です。
さて,そんな便利なEvernoteですが,私のような使い方であれば基本的に無料のベーシックプランで問題ありませんでした。容量の制限が気になったこともありませんし,オフラインでノート共有できないときも最悪iPhoneがあります。どうしてもiPadやMBAで見たいときはデザリングすればいいですし。ところが,どうやらベーシックプランで利用する端末の制限がかかってしまうようなのです。私は現在ウェブアプリの他にiPhone,iPad,MBAでEvernoteを同期しており,2台までの制限だとどれか一つを切り捨てなければいけないことになります。MBAを買ってからは基本的に常にMBAを持ち歩いて作業しているので,iPadの利用頻度は以前に比べるとかなり減ってきています。そう考えると,iPadでは利用せずにiPhoneとMBAだけですませるということも考えられます。
アップグレードするとなると,容量が増えてオフラインでも使えるプラス版で年間3100円、さらにPDF内の文字検索にも対応するプレミアム会員で年間5200円になります。いままでベーシック版の機能だけで事足りていた私からすると,利用端末の制限を解除したいというだけで年間3100円も支払うべきなのか非常に悩ましいところです。
さてどうしましょう。もう少し悩みます。
なにをゆう たむらゆう
おしまい。
Evernoteは6月29日、価格プランを改定すると発表しました。改定のポイントは2点。無料ユーザー(ベーシックプラン)がノートを同期できる端末を最大2つに制限することと、有料プラン(プラスプラン、プレミアムプラン)を大幅に値上げすることです。価格改定は2016年8月15日以降の更新日から適用されます。
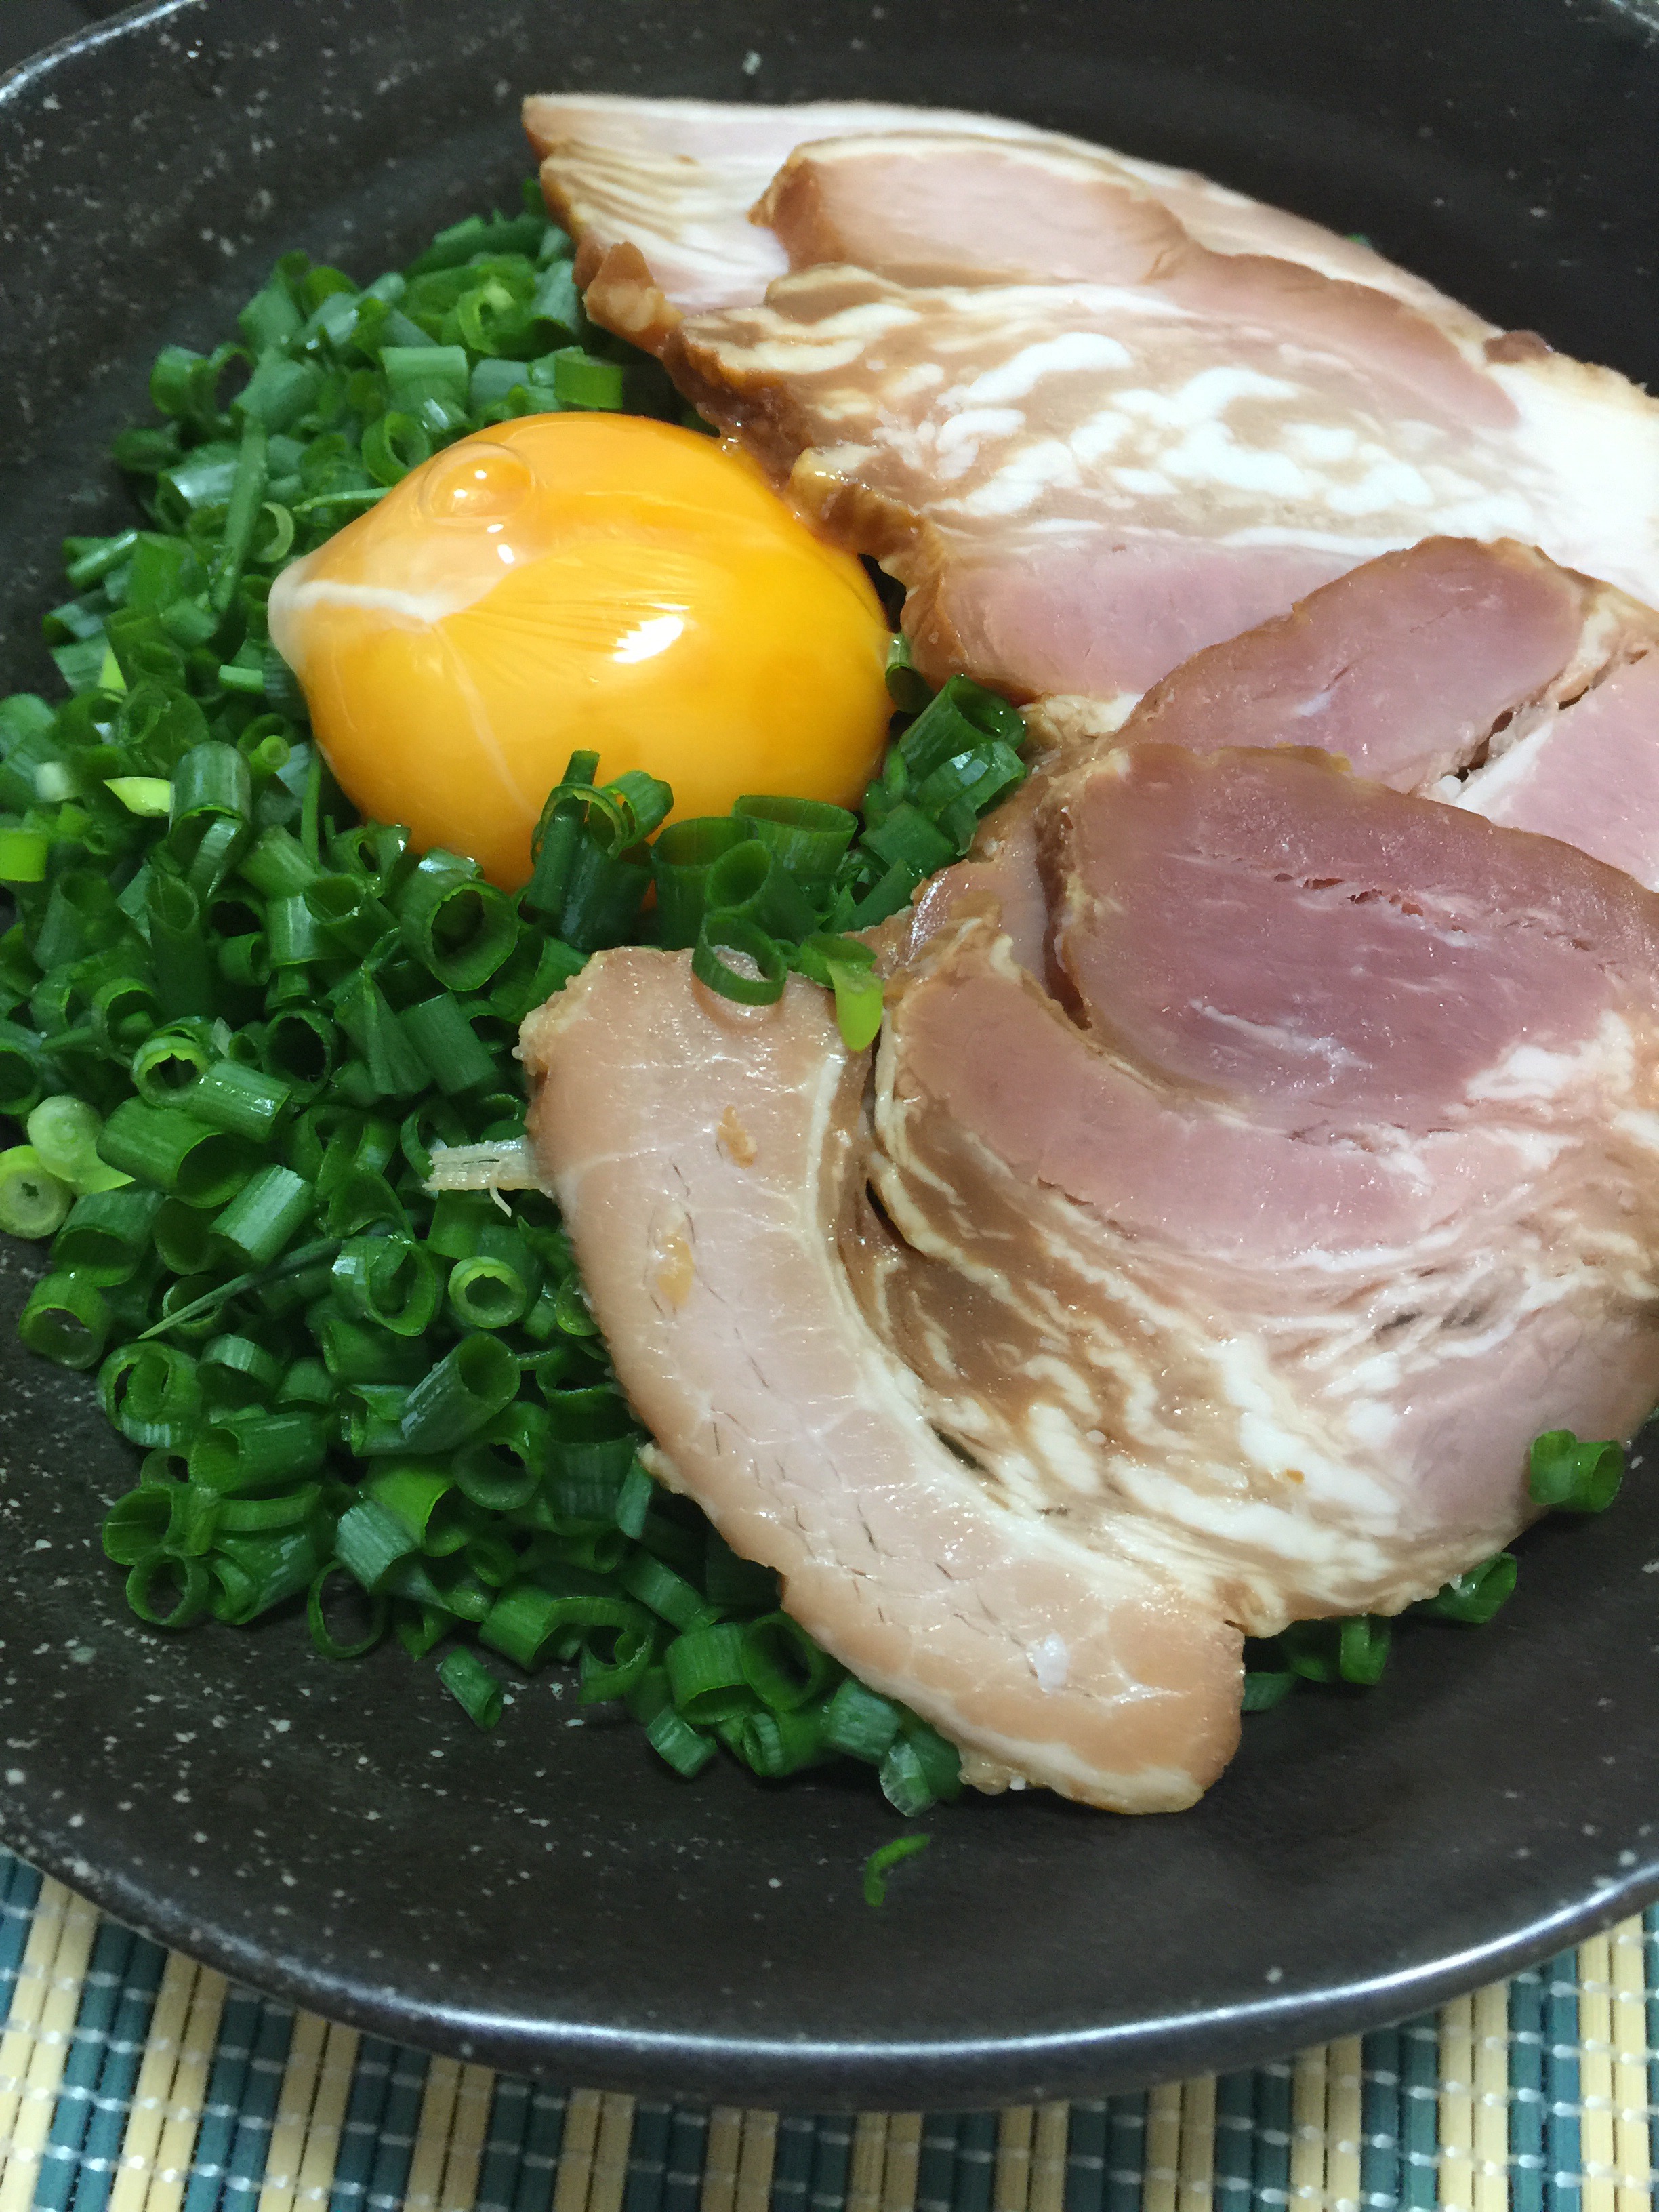
油そばネギ盛り。今回は手抜きして焼豚はスーパーで買ったやつ
Language Teaching ResearchでTaskの特集号が出ていました(裏話によると後づけで採択された論文を集めた特集号らしい)。そこで,とある論文を見たら,”linear mixed model analysis (LMM)”が使われたと書いてありました。
いわゆるLMEのことかな?と思いつつ読んでいると,固定効果とランダム効果をいれたモデルでうんぬんと書いてあるのでやっぱりそうかと。general linear modelというのは一般線形モデルなので普通の回帰分析や分散分析と同じだけれど,ランダム効果をいれたものは(general) linear mixed-effects modelと呼ばれる(ただし普通GLMMはgeneralized linear mixed-effects model)。つまりmixed effectsとつくものは変量効果をいれたもの。ちなみにgeneralized modelというのは確率分布が正規分布以外のもの。
結果のところを読んでいると,なんかF値とか報告されています。3つの2次交互作用と1つの3次交互作用がモデルに入っていると書いてあるのに交互作用項がどうなったのかとかの報告が一切ありません。そしてランダム効果の推定値も報告されていません。分析に用いたソフトウェア(RなりSPSSなりSASなり)の報告もありません。
??????????????????????????????????????
え?ていうかこれただ分散分析やっただけじゃないのか?
ちなみに,「GLM (general linear model)で分析しました」みたいなことが書いてある論文も以前みたことがあります。それって結局ただの分散分析ですよねみたいな。普通GLMはgeneralized linear modelの略です(APA第6版のp.119にもそう書いてある)。別に分散分析やったなら分散分析やったでいいからそう報告してほしいですね。なんか変にかっこつけてるのかなんなのか知らないですけど素人騙しでmixed-model使ったとかそういうの本当にやめてほしいです。ていうか査読でチェックされなかったんかいなこれっていう…
あまりLTRをdisると同じ号に載ってる先輩の論文にまで飛び火するのでこの辺にしておきましょう(※彼の論文は何も悪くありません)。
なにをゆう たむらゆう。
おしまい。
最近毎週火曜日に体育館でバスケをやっています。後輩と一緒に。名古屋に来てからなかなかバスケする機会がなかったのですが,久しぶりにやると楽しいですね。バスケ最高。運動って最高。とはいえ身体もどんどん動かなくなっていてしんどいです。それでもシュートはまだ入るのでなんとかなっています。
先週は体育館にいた人たちに声をかけてピックアップゲームしました。やっぱゲーム形式でやると楽しいですね。身体の衰えは隠せませんが,いつかまた駒場の仲間や大学のサークルの仲間とバスケやりたいです。動画はしびれるクラッチショット集。
iPhoneとiPadでは,Calendars 5というカレンダーアプリを長いこと使っています。基本はGoogleカレンダーに予定をいれて,それを同期させるという感じ。でも,結構前から日本の休日設定がCalendars 5にうまく同期されないという問題が発生していました。レビューを見てもこのことが書いてあったりしますが,アップデートしても改善されておらず,ネットを探しても解決策がわかりませんでした。Googleカレンダーの方にはちゃんと休日が表示されているので,Calendars 5に同期する段階でなにか問題があるということはわかったのですが。
それでついさっき,Calenders 5内でGoogleアカウントから一度サインアウトして再ログインしたらちゃんと表示されるようになりました。最初にiPadで再ログインして表示されるようになったので,iPhoneのアプリも開いてみると,こちらは表示されておらず,iPhoneでもサインアウトしてから再同期の手順でまたちゃんと休日が表示されるようになりました。
めでたしめでたし。
なにをゆう たむらゆう。
おしまい。
たまに簡単にご飯をすませたいとき,麺類が楽ですよね。パスタでもいいんですが,いつもパスタだと飽きるのでバリエーションがほしい。たまたまつけ麺用の中華麺が買ってあったので,これで何か作ろうかと思いました。ちなみに私がいつもスーパーで買うのはこちらです。
つけ麺を作るとなるとスープが必要ですよね。でもめんどくさい。そこで,スープを作らなくても良い油そばができないかと考えました。そしてこれが簡単なのに意外に美味しかったので以下に適当にメモしておきます。
材料
作り方
1. 鍋にたっぷりのお湯を沸かして麺を茹でます
2. どんぶりに調味料をいれてよく混ぜておきます。塩(醤油)とだしの量で味の濃さを調節してください
3. 麺が茹で上がったら湯切りしてどんぶりにそのまま盛りつけて,あとはお好みのトッピングを載せるだけ
4. 下の調味料をよく麺に絡めてから食べましょう

今回は七味をパラパラとかけています
たったこれだけです。今回は自家製の豚バラチャーシューを作って載せています。これは豚バラブロック(たまたまスーパーで安かった)を酒,生姜,にんにくと一緒に茹でて脂を落として,醤油と味醂を1:1で混ぜたつけ汁を入れたボールの中でぐるぐる回しながらまんべんなく染み込ませておきます。これは前日の夜にやっておいて,食べる前にオーブンで片面ずつ焼色をつけて,またつけ汁をつけて反対側も焼くという感じで焼色をつければ完成。別にチャーシューは買ってきてもOKですし,メンマとかもうまいでしょう絶対。ポイントは調味料のおろしニンニクですかね。にんにく苦手な方はこれなしでもOKですが,ちょっと物足りなさを感じると思います。
これ入れたら美味しそうというアイデアがあったら教えて下さい。
ちなみに,こういうやり方もあるみたいです。
なにをゆう たむらゆう
おしまい。
今までデータをあれこれいじったり記述統計出したりするのはExcelで色々やってからRにいれて分析という流れでした。dplyr使ったら便利そう…というのはなんとなくわかっていたんですが,自分がよく扱うようなデータセットの構造に対してどうやって使えば今までやってたことが楽になるのかいまいちイメージがわかずにずっと放置していました。最近色々あってようやく基礎中の基礎だけを覚えたので以下メモ書きです。
#事前・事後・遅延事後でCAFのデータを取ってるというデザイン
pre.fluency <-rnorm(50,mean=10,sd=2)
pre.accuracy<-rnorm(50,mean=7,sd=2)
pre.complexity<-rnorm(50,mean=4,sd=2)
post.fluency<-rnorm(50,mean=14,sd=4)
post.accuracy<-rnorm(50,mean=10,sd=3)
post.complexity<-rnorm(50,mean=7,sd=2)
delayed.fluency<-rnorm(50,mean=12,sd=2)
delayed.accuracy<-rnorm(50,mean=8,sd=1)
delayed.complexity<-rnorm(50,mean=6,sd=1)

#それぞれの列を横にくっつける
dat<-cbind(pre.fluency,pre.accuracy,pre.complexity,post.fluency,post.accuracy,post.complexity,delayed.fluency,delayed.accuracy,delayed.complexity)
dat<-as.data.frame(dat) #データフレーム型に変換
dat$subject<-rep(1:50) #実験参与者のID列をつける
head(dat)
##   pre.fluency pre.accuracy pre.complexity post.fluency post.accuracy
## 1   11.916630     7.480500       4.644798     8.431656     13.070707
## 2   10.719751     7.090714       6.566487    13.652658     11.462576
## 3   11.980852     6.182161       5.731289    16.580042     11.287683
## 4   11.109400     7.256950       5.897070    16.966183      9.497555
## 5   10.488391     5.449349       2.673285    15.778588      9.994575
## 6    9.076144     8.621538       2.122296     9.465845      7.577611
##   post.complexity delayed.fluency delayed.accuracy delayed.complexity
## 1        8.639772       12.961946         7.740613           7.042510
## 2        6.397390        9.921947         7.520258           6.951231
## 3        6.917590       10.478401         9.378301           4.972710
## 4        5.897965        6.738074         8.983224           5.045168
## 5        6.214526       10.694636         8.510670           5.184044
## 6        7.644466        8.666421         8.863990           4.719461
##   subject
## 1       1
## 2       2
## 3       3
## 4       4
## 5       5
## 6       6
参考までに以前tidyrの紹介を書いたブログ→変数が多い研究デザイン系の縦横変換(tidyr)
library(tidyr)
dat%>%
  gather(key=variable,value=score,-subject)%>%
    separate(col=variable,into=c('test','measure'))->dat2
head(dat2) #test, measure, scoreという列ができてるか確認
##   subject test measure     score
## 1       1  pre fluency 11.916630
## 2       2  pre fluency 10.719751
## 3       3  pre fluency 11.980852
## 4       4  pre fluency 11.109400
## 5       5  pre fluency 10.488391
## 6       6  pre fluency  9.076144
でもさーこうやってlong型にしちゃうとさー例えば事前のときの流暢さの指標の平均値とか出せないじゃん?wide型になってたら全部横にならんでるから列ごとに平均求めればいいだけじゃん?
library(dplyr)
dat2%>%
    group_by(test)%>%
    group_by(measure,add=T)%>%
  summarise_each(funs(mean,sd,min,max),-subject) #summarise(mean=mean(score),sd=sd(score),min=min(score),max=max(score))でも同じ。もともとsummarise_eachは複数列に同じ関数を適用するときに威力を発揮するものだけど
## Source: local data frame [9 x 6]
## Groups: test [?]
##
##      test    measure      mean        sd        min       max
##     (chr)      (chr)     (dbl)     (dbl)      (dbl)     (dbl)
## 1 delayed   accuracy  8.050833 1.0231177  5.5291358 10.250133
## 2 delayed complexity  6.043974 0.8633653  4.1740878  7.908483
## 3 delayed    fluency 11.966818 2.2327496  6.7231359 15.657528
## 4    post   accuracy  9.529745 2.4594148  2.7470626 16.876272
## 5    post complexity  7.211917 1.9710329  2.3591702 11.759346
## 6    post    fluency 14.624789 3.8821630  7.3521391 21.161635
## 7     pre   accuracy  6.941050 1.7114477  3.3338811 10.798454
## 8     pre complexity  4.326063 2.1271468 -0.7051241 10.391882
## 9     pre    fluency 10.239550 2.0043330  5.8044643 14.556087
※このデータの場合,test,measure,score,subjectの4つしかなく,グルーピング変数で2つ使っていて,-subjectするので必然的にscoreだけの計算になるけど,もっと列数多くて記述統計出したいのは1つだけの時は列を指定してあげる(下の例参照)
#こんな感じ
#dat2%>%
#  group_by(subject)%>%
#  group_by(test)%>%
#  group_by(measure,add=T)%>%
#  summarise_each(funs(mean,sd,min,max),score)
#こんな感じ
#dat2%>%
#  group_by(subject)%>%
#  group_by(test)%>%
#  group_by(measure,add=T)%>%
#  summarise_each(funs(mean(.,na.rm=T),sd(.,na.rm=T),min(.,na.rm=T),max(.,na.rm=T)),score)
ハッ,なに言ってるのこの人そんなのdplyrの威力をぜ~んぜんっ活かせてないんだからね!っていうのもあるかと思うのでもっと勉強したいと思いますがとりあえずtidyrからのdplyrを外国語教育研究のありそうなデータセットの形でやってみるとこんな感じになりますよというお話でした。
参考サイト
なにをゆう たむらゆう。
おしまい。
dat2%>%
  spread(measure,score) ->dat3 #measureごとにscoreの列を作る
head(dat3)
##   subject    test  accuracy complexity   fluency
## 1       1 delayed  7.740613   7.042510 12.961946
## 2       1    post 13.070707   8.639772  8.431656
## 3       1     pre  7.480500   4.644798 11.916630
## 4       2 delayed  7.520258   6.951231  9.921947
## 5       2    post 11.462576   6.397390 13.652658
## 6       2     pre  7.090714   6.566487 10.719751
dat3%>%
  group_by(test)%>%
  summarise_each(funs(mean,sd,min,max),-subject)
## Source: local data frame [3 x 13]
##
##      test accuracy_mean complexity_mean fluency_mean accuracy_sd
##     (chr)         (dbl)           (dbl)        (dbl)       (dbl)
## 1 delayed      8.050833        6.043974     11.96682    1.023118
## 2    post      9.529745        7.211917     14.62479    2.459415
## 3     pre      6.941050        4.326063     10.23955    1.711448
## Variables not shown: complexity_sd (dbl), fluency_sd (dbl), accuracy_min
##   (dbl), complexity_min (dbl), fluency_min (dbl), accuracy_max (dbl),
##   complexity_max (dbl), fluency_max (dbl)
library(psych)
apply(dat,2,describe)
## $pre.fluency
##   vars  n  mean sd median trimmed  mad min   max range skew kurtosis   se
## 1    1 50 10.24  2  10.45   10.24 2.21 5.8 14.56  8.75    0     -0.6 0.28
##
## $pre.accuracy
##   vars  n mean   sd median trimmed  mad  min  max range skew kurtosis   se
## 1    1 50 6.94 1.71   7.15    6.93 1.79 3.33 10.8  7.46 0.06    -0.43 0.24
##
## $pre.complexity
##   vars  n mean   sd median trimmed  mad   min   max range skew kurtosis
## 1    1 50 4.33 2.13   4.09    4.33 2.07 -0.71 10.39  11.1 0.09     0.33
##    se
## 1 0.3
##
## $post.fluency
##   vars  n  mean   sd median trimmed  mad  min   max range  skew kurtosis
## 1    1 50 14.62 3.88  14.78   14.67 5.19 7.35 21.16 13.81 -0.09    -1.27
##     se
## 1 0.55
##
## $post.accuracy
##   vars  n mean   sd median trimmed  mad  min   max range skew kurtosis
## 1    1 50 9.53 2.46   9.48    9.44 2.69 2.75 16.88 14.13 0.24     0.67
##     se
## 1 0.35
##
## $post.complexity
##   vars  n mean   sd median trimmed  mad  min   max range  skew kurtosis
## 1    1 50 7.21 1.97   6.93    7.22 2.18 2.36 11.76   9.4 -0.07    -0.31
##     se
## 1 0.28
##
## $delayed.fluency
##   vars  n  mean   sd median trimmed  mad  min   max range  skew kurtosis
## 1    1 50 11.97 2.23  12.42   12.09 2.51 6.72 15.66  8.93 -0.42    -0.52
##     se
## 1 0.32
##
## $delayed.accuracy
##   vars  n mean   sd median trimmed  mad  min   max range  skew kurtosis
## 1    1 50 8.05 1.02      8    8.06 1.06 5.53 10.25  4.72 -0.15     -0.2
##     se
## 1 0.14
##
## $delayed.complexity
##   vars  n mean   sd median trimmed  mad  min  max range skew kurtosis   se
## 1    1 50 6.04 0.86   5.97    6.05 1.01 4.17 7.91  3.73 0.02    -0.65 0.12
##
## $subject
##   vars  n mean    sd median trimmed   mad min max range skew kurtosis   se
## 1    1 50 25.5 14.58   25.5    25.5 18.53   1  50    49    0    -1.27 2.06

