カテゴリー別アーカイブ: 研究

変数が多い研究デザイン系の縦横変換(tidyr)

先日ついにtidyrパッケージで縦横変換をやってみた。今までずっと覚えなきゃなと思ってて結局億劫でやってなかったんだけれど手伝いで仕方なく。

データハンドリングで,横に広がる(列数の多い)wide-formatのdataを分析に便利なlong-formatに変換するというのは,分析をやるまえのデータ整形の過程で必ず通らなければならない道。Excel上で地道にやるのもあるにはあるだろうけど,Rのtidyrを使えばすぐできるというお話。これ系の話はググればネット上にゴロゴロ記事が転がっている。なので,今回は具体的に外国語教育研究系のデータ分析ではどんなときに役に立つかなーという話です。特に無駄に変数が多い時なんかは結構役に立つと思います。

sample data

sample data

適当にこんな感じでデータが入っているとします(数値は乱数)。事前・事後・遅延事後のテストがあって,それぞれで流暢さ(fluency),正確さ(accuracy),複雑さ(complexity)の指標があるみたいな。1列目には被験者番号があって,それぞれの列名は”test.measure”という感じでドット区切りにしてあります。で,これを,「事前・事後・遅延事後」の3つのカテゴリカル変数からなる”test”列と,3つの指標(CAF)の”measure”列の2列に分解しましょうという話し。

R上に上のようなデータを読み込みます。

read.table関数で読み込んだ場合(※MacなのでちょっとWindowsと違います)

read.table関数で読み込んだ場合(※MacなのでちょっとWindowsと違います)

まずはパッケージの準備

install.packages(“tidyr”) #パッケージのインストール

library(tidyr) #tidyrパッケージの呼び出し

datに入っているデータフレームをまずは,変数名の列(variable)とその値(value)の列に集約します。key=変数名の列,value=値の列という引数指定です。

#%>%はパイプ演算子。以下の関数で扱うデータフレームを指定するということです

dat %>%

#-subjectでsubjectの列を除外。変換したdataをdat2に入れる

gather(key = variable,value = value,-subject) -> dat2
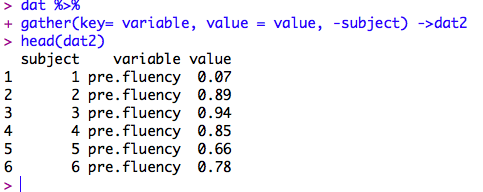
long formatのデータに変換されました

long formatのデータに変換されました

これで変数名を1列に集約できました。ただし,この列にはpre, post, delayedというテスト実施時期の情報と,fluency, accuracy, complexityという指標の情報が混ざってしまっています。これを,2列に分けます。

dat2 %>%

#colで分けたい列名,intoで分けた後の列名を指定。sepでセパレータを指定しますが,デフォルトはあらゆる非アルファベットになっているので,ドットなら指定しなくても大丈夫

separate(col = variable, into = c(‘test’, ‘measure’)) -> dat 3

さて,dat3の中身を確認してみると…

long formatのデータに変換されました

long formatのデータに変換されました

おおおおー!!!!!

というわけで,横に変数がたくさんある場合もこのtidyrのgatherとseparateを使えば簡単にlong型に変換できそうです。


参考サイト:http://meme.biology.tohoku.ac.jp/students/iwasaki/rstats/tidyr.html

なにをゆう たむらゆう

おしまい。


データを取る前に考えよう

ストレスが溜まっているのかなんなのか帰り道にセブン-イレブンでチーズとワインを買って飲むとかいう珍しいことをしているという言い訳を最初に書いておこうと思います。それから,自戒もたっぷり込めていることも申し添えておきたいと思います。

データ分析の方法の相談についてです。色んな所で起こっていることだと思うし色んな人がきっと同じようなことを考えているだろうと思います。一言でいうと,データを取る前に相談してみましょうということです。データを取ったあとに,「このデータってどうやって分析すればいいですか?」っていう質問は結構つらいところがあったりします(恐れ多くもなぜだかこういう質問をされる立場に私もなってしまいました)。なぜなら,本当にその質問者の方が調べたいこと,明らかにしたいことが,そのデータ収集方法で明らかにすることができるのかちょっと怪しかったりすることがあるからです。

そういう状況にならないために重要なことは,研究課題を見つけて,それを具体的な実験計画なりに落としこむ際に,その先のことまでちょっと考えてからデータ収集をしてみることだと思います。つまり,

こういう方法を使うと,こういうデータを収集することができる。それをこういう分析にかければ,こういう結果が得られるはず。もしこういう結果が得られた場合,それはこういうことを意味していると解釈できるだろう。

みたいなことを考えてから実験を組んで,データを取っていただきたいなということです。そうすれば,データを取ってからどうしたらいいかという質問が来ることはなくなるからです。上述の事でイマイチ自分がうまく説明できないとなったら,その時点で相談をすればよいと思います。そうすれば,実はその方法で得られたデータで,質問者の方の主張をするのはちょっと違うので,こういうデータ収集をしないといけませんよ,なんてアドバイスができたりするかもしれないからです。これって仮説検証型の研究でも探索的な研究でも同じだと思います。たとえ探索的な研究だったとしても,得られた結果に対してなんらかの解釈を加える必要はあるはずですから。研究課題がwh疑問文で始まる形であったとしても,結果に対しては,きっとこういう理由でこうだったのだろうということを言えなければいけないわけですし。

データをとって,分析をしてみて,これであってるのか不安だから相談してみようということもあるのかもしれませんが,それって別にデータ取る前にもできることなんですよね。

こういう研究課題をもっていて,これを明らかにするためにこういう分析をしてこういう結果が得られたらこういう解釈ができると思うのですが,これで合ってますか?

ってデータ取る前に相談すればすむと思うのです。なのにどうして,「データを取ったあとにこれってどうやって分析すればいいんですか?」ってなってしまうのでしょう。

これはあくまで持論なのですが,研究って,研究のデザインとか実験計画ですべて決まると私は思っています。面白いなと思う研究はやっぱりデザインがしっかりしていて,分析の結果から得られたことの解釈がとってもシンプル(注1)なんです(そういう研究が良い研究だと思う私からすると,discussionを長々と書いている論文やそれが良しとされる風潮,また「discussionが短い」みたいなコメントってなんだかなと思ったりします)。それって,デザインを練る段階で色んなことを考えているからなんですよね。研究の計画を立てる段階で,データの分析方法まで明確にイメージできない場合は,データ収集に入るべきではないと私は考えています。私の場合は基本的に,ある研究で行われることを考えることは,R上で分析を行う際のデータセットの形をイメージすることとほぼ同義です。変数のデータフレームがイメージできていて,それをどうやって分析すれば何をどうしていることになるのか,こういう結果になったらそれはどう解釈するのか,また別の結果がでたらそれをどう解釈するのかまで考えられて初めて研究のデータ収集ができるのではないでしょうか。

こういった考えが当たり前になれば「統計屋さん」(私は違いますけど)とか言われる人たちもずいぶん楽になるのではないかなと思っています。

なにをゆう たむらゆう

おしまい。

*注1: だからといって,t検定一発で明らかになることってそんなにはないとは思います。少なくとも今なら昔はt検定一発だったこともGLMMするでしょう。例えば正答率の平均値をt検定というのはもはや時代遅れになりつつあるわけですし。

JASELE2015熊本大会発表資料

こんにちは。明日から始まる全国英語教育学会(JASELE)熊本研究大会で,同じ名古屋大学大学院の後輩と,一応先輩の福田さんとの共同研究プロジェクトの発表があります。2日目(8月23日)の朝10:30から第5室(1141)です。anomaly detection(異常検知)の手法を用いずに,統語的に表される等位接続詞の複数(e.g., the boy and the girl)と,複数形態素によって表される複数(e.g., the teenagers)の処理が異なることを示した研究です。元にしているのは,以下の論文です。

Patson, N. D., & Ferreira, F. (2009). Conceptual plural information is used to guide early parsing decisions: Evidence from garden-path sentences with reciprocal verbs. Journal of Memory and Language, 60, 464–486. http://doi.org/10.1016/j.jml.2009.02.003

当日使用する投影資料はslideshareからアクセスできますので御覧ください。なお,当日印刷した資料を配布する予定はありません。ご了承ください。

なお,私が第二著者として参加しているライティング関係の共同研究プロジェクトの発表もあります。こちらは2日目(8月23日)の朝一番,9:30から第12室(1242)です。

川口勇作・田村祐・福田純也 「推敲時の筆記ランゲージングにおける学習者の注意配分とライティングの質の向上―フィードバックの有無に焦点をあてて―」第41回全国英語教育学会熊本研究大会. 熊本学園大学.

こちらの発表資料は,代表者の福田さんにご連絡いただければスライドをお送りします(たぶん)。

JSLS2015@大分

今週末に大分の別府で開催される言語科学会の研究大会で共同研究のポスター発表があります。1年前から追いかけているthere構文における主語と動詞の一致についてです。今回のポスターには盛り込めませんでしたが,別で取ってるデータもあるのでそれもまとめて今年中にどこかに論文を投稿予定です。

昨年JABAETで発表したときの資料はこちら。


今回のポスターはこちら。

CELES2015和歌山大会発表資料

中部地区英語教育学会和歌山大会で,同じ名古屋大学大学院の後輩である西村くんと,共同研究の発表があります。語彙のネットワークモデルである階層改訂モデル(Kroll & Stewart, 1994)に基づき,文法の情報である複数素性がどのように処理されているかをL2英単語をみてからL1翻訳のマッチングを判断する課題と,L2英単語をみたあとに写真を見るという課題で検討したものです。資料のPDFはslideshareからアクセスできるようになっていますので御覧ください。なお,当日印刷した配布資料の用意はありませんのでご了承ください。

Schulz (2001)の感想

6/6に,名古屋大学にて第14回日英・英語教育学会(JABAET)研究会が開かれることになりました(詳しい内容はこちらから)。

そこで,論文批評というのがあり,私が文法指導のビリーフに関する次の論文の概要報告を担当することとなりました。

Schulz, R. A. (2001) Cultural differences in student and teacher perceptions concerning the role of grammar instruction and corrective feedback: US – Colombia. Modern Language Journal, 85, 244 – 258. doi: 10.1111/0026-7902.00107

私の概要報告のあと,JABAETの会長である安間一雄先生(獨協大学)より論文の批評があります。私に与えられたのは15分のみで,私のコメントは本番で話すことはなさそうなので,ここに論文を読んだ私の感想を書いておきます。

  • 質問紙調査というものを用いた調査としては極めて質が低いと言わざるを得ない。結果的に質問紙の1項目ずつのパーセンテージを恣意的に定めた10%という基準の差がみられたか否かの報告に終始していて,結局なにを測りたかったのが不明のまま。
  •  本来,質問紙によってある構成概念を測定することを試みる場合,それが適切に測定できているかの検証を行う必要がある。Schulz(1996)においてもそのような手順を経て質問紙の開発を行ったという記述が一切ない。また,文化的に異なる2群と,学習者・教師という2群が設定されているが,それぞれの質問紙が同じ構成概念を測定しているのかどうかも定かではない。したがってそのような質問紙を用いて得られた結果を比較することに本当に意味があるのかどうかも疑わしい。
  • 質問紙項目のワーディングにかんしても,”formal study of grammar”と”study of grammar”が指すものは同じなのか違うのか,あるいは”communicative ability”と聞いたときに回答者が思い浮かべるものは同じであるのかが疑問。
  • さらに,タイトルに有るのは”role of grammar instruction”であるのにもかかわらず,質問紙ではinstructionという言葉は使用されていない。教員側の質問では,なぜか”学習者がどう思っているかを教師がどう思うか”というような質問項目があり,これがなぜ”the role of instruction”に関する教師のビリーフを測定しているといえるのかも不明。学習者側からのlearningと,教師側からのteachingが完全に一致することはないとはいえ,教師側の設問文をみると教師の指導観に関する質問であったり学習者の教師観に関する質問であったり,一見してこれらが教師のビリーフを測定しているのかが疑問である。ただし,理論的な背景に基づいて教師の指導観という構成概念の下位尺度として,教員の指導観と学習者が教師や教師の行う指導に対してどのように感じていると思うか,という2つの構成概念を仮定するならば話は別であるが。
  •  誤りの訂正に関しても同様で,recastsのような暗示的訂正から,規則の説明までも含むようなかなり明示的訂正までかなり幅がある上に,スピーキングとライティングというモードの違いでも訂正の出し方,またその訂正のあと学習者になにを要求するかもかなり変わってくる。2001年時点でもCFでこのような区分がされていなかったということはないはず。
  •  「明示的指導」にも様々なバリエーションがあるのと同様に「誤り訂正」にもバリエーションは豊かである(むしろ前者のバリエーションはかなり無視されている感があるが)。これらの指導効果のメタ分析をするにあたっても,調整変数分析で細かく検討されるわけで,「明示的指導」や「誤り訂正」に対するビリーフといった構成概念を測定する場合にも,これらが捨象されてはかなりぼやけたものしかみることができないはずだ。
    こうした「粗さ」がすべてと言っても過言ではない。何度もいうが,結果的になにが明らかになったのかがわからない。この項目ではこっちの差があってこの項目では差がなかったとか言われても質問紙(とも呼べない代物だが)の1項目の1反応(の5段階をさらに3段階に圧縮している)の差(10%だったら差ありで9%だったらなしという恣意的基準に基づく)なんてもので何かを言おうとするな。私自身が「測ること」に対して厳しいところにいるからとかそういう問題ではなく,この質問紙に何も思わないって人がいたら結構ヤバイだろうと思う。
  • この研究の成果を結局どこに還元したいのかが不明瞭。実際に教室で言語を教える実践者に対して,学習者と教師自身のビリーフが異なっているようなことはないか,そこに気をつけるべきであるということなのかと思って読み進めると,最後には教員養成のおいての,というような話も出てくる。教師のビリーフがSLAの文献に基づいているかそれとも自身の学習経験に基づいているか,というアメリカとコロンビアの比較も,そもそも文化的差異というよりかは教員養成プログラムにおいてSLAや応用言語学,外国語教育研究の文献を読んだ経験があるかどうかが大きいはずである。研究の成果はほとんど英語で書かれているわけであるから,教えている言語は違えど,アメリカの教師(英語母語話者)がそのような文献にアクセスして読むことと,英語を外国語または第二言語として学習した教師が英語の文献を読むことを比べれば,明らかに前者の方がハードルが低いはずである。日本に限って言えば和書でSLAや外国語教育研究の概説書もそれなりに出版されているわけだが,英語教員の中で,教員養成の段階で(実際に教壇に立ってからでもいいが)どれほどの人が「研究の成果を参照しながら自分の指導を考える」というような経験をしてきたのだろうか。修士課程を出て教員になったり,または大学院に戻って勉強したという教員ならば,学術書や専門書を手にとることもあるだろうが。
  • 自身の経験に基づいて教えることがなぜダメで(ダメとははっきり言っていないがこういう対比されるとそう読めてしまうのは深読みし過ぎかもしれない),どうしてSLAを参照している方がよいのかという観点も述べられておらず,外国語環境で教える語学教師は自身のビリーフに依っていてアメリカではSLAちゃんと参照しているとか言われても(しかもそれが少人数のインタビューと自分の身の回りにおいての話だけに基づく主張),だからなんなのかとなるしそれが明らかになったところで分野がどうなるのかと思う。常に知識をアップデートし続けるべきなのだというのならばそれはうなずけるわけだが,SLAといっても玉石混交で細かい部分では「ジャスティス大会」がずっと続いており,「どの文献を参照すべきか」は研究者でも難しい問題なのではないだろうか(いわんや教師をば)。

とにかく表が多くて項目ごとにパーセンテージをひたすら比較するだけで読みづらく,何がわかったかもあやふやで,それがどう説明されるということもなく,悶々させられました。10年以上も前だからしょうがないよねって感じでもないしModern Language Journalは昔は今ほどレベル高くなかったというのはこういうことなんだなぁと思ったのでした(遠い目

おしまい。

なにをゆう たむらゆう


書けなかったacknowledgement

ご無沙汰しております。新年度が始まり,大学院のゼミ,非常勤の授業,自分の研究,と,慌ただしい生活が始まりました。

そんな中,昨年度acceptされた論文が,ついにpublishされて手元に届きました。全国英語教育学会の紀要であるAnnual Review of English Language Education in Japanです。

先輩の草薙さんとの共著で,

Asymmetrical representation in Japanese EFL learners’ implicit and explicit knowledge about the countability of common/material nouns.

という論文です。合格点ギリギリで通ったので,査読者との相性も含めて,「ラッキー」だったのだなと思っています。今年は本数も多くて紀要自体分厚めでしたし。その反動で,来年はちょっと厳しくなるのではないかなと邪推しています。

Anyway. 私自身,論文をすっきりと書くのがどうもニガテで,うまくまとめることができず,いつも規定の語数(またはページ数)におさめるためになんとか削って削ってギリギリにおさめるということを繰り返しています。ARELEに載った論文も例外ではなく,正直16ページにおさめるのに相当苦労しました。その関係で,謝辞を書く余裕もなくなってしまいました。というわけで,あの論文のacknowledgementをこの場を借りて書きたいと思います。

まず,あの論文は,昨年度の全国英語教育学会徳島研究大会での口頭発表をもとにしたものです。台風で天候も悪い中,朝一番の私の発表に来てくださった方々,またコメントをいただいた方々にまずはお礼を申し上げます。

また,データを取って口頭発表する前の段階で,名城大学の松村先生が主催する勉強会でも発表させていただきました。その勉強会でもコーパスの頻度データの話などに関して有益なコメントをいただきました。松村先生をはじめ,桃山学院大学の島田先生,静岡文化芸術大学の横田先生,愛知教育大学の藤原先生に感謝を申し上げます。

学内のゼミの方々にもご指導頂きました。口頭発表の後,論文の体裁として書き上げたものを,木下先生のゼミで発表させていただきました。もうデータも取って論文の形になっていたものでしたから,あとは「どう書くか」というところだったわけですが,うまく伝わっていない部分が明らかになり,そこを修正した上で最終的には提出しましたので,木下先生をはじめ,ゼミでコメントをいただいた方々にもお礼を申し上げます(指導教官のY先生のゼミでは一切発表もせずにsubmitしたものというのがヒィィという感じではあります)。

最後に,同じ研究室の隣の隣の席の福田さん。彼の論文(彼の論文もARELEの同じ号に掲載されています!)の謝辞には私の名前が入っていたので(さらにはARELEに掲載された論文を引用していただいてもいる…!),私の論文で彼に対する謝辞を述べられなかったことはとても残念でなりません。毎日のように意見交換し,彼と話す中で自分の考えが整理されていったことは言うまでもありません。その過程がなければ,あの論文が採択されていたかどうかはわからないといっても過言ではありません。本当に感謝しています。そして,これからも一緒に(あと1年しか同じ研究室で過ごす時間はないかもしれませんが),切磋琢磨していきましょう。彼と共著の論文を出版することが,私の今年度の目標でもあります。

同じ大学院生で,単著でARELEに掲載されている方がたくさんいる中で,このようにブログで謝辞を綴るなどというのは「舞い上がっている」のかもしれません。しかし,私にとっては初めての第一著者としての掲載論文であり(査読なしの論文を含めても),私の出発点ともなる論文になることでしょう。これからも,「一発屋」だとか,「草◯の名前がないと載らない」等々言われないよう,一層研究に励んでいきたいと思います。

ということで,これからもご指導ご鞭撻のほどよろしくお願いします。

IMG_3280

なにをゆう たむらゆう

おしまい。

読解や聴解と語彙サイズ

Language Teachingにまたこれ系の論文出ましたね。

Schmitt, N., Cobb, T., Horst, M., & Schmitt, D. (2015). How much vocabulary is needed to use English? Replication of van Zeeland & Schmitt (2012), Nation (2006) and Cobb (2007). Language Teaching. Advanced online publication. doi: 10.1017/S0261444815000075

僕自身語彙とかの研究やっているわけではないのですが,「現場受け」しそうだよなぁという印象はありますこういうの。Language Teachingは明示的にreplicationとうたっている研究が最近多い感じしますね。それはいいことだと思います。

ちなみに,今年度後期の授業でvan Zeeland & Schmitt (2012)のレビューをしました。資料はこちら。

読解にしろ聴解にしろ,「読めた」「聞けた」「理解できた」とするためには正答率何%が適切なのか?またそれはどのような基準で決めるのか。というのがすごく難しい問題だよなという印象です。

なにをゆう たむらゆう

おしまい。

パイロットスタディはなんのためにやるか

なんでもいいけれど,パイロットスタディの結果から何かの効果を示したいとか母集団への一般化をしたいとかいうことなら統計的仮説検定なりモデリングなりすればよいでしょう。
だけれども,「パイロットだから一般化線形モデルで結果を一般化するのはどうなの」とかいうのを聞くと,じゃあなんでt検定はいいの?となるわけです。一般化線形モデルの一般化(generalized)というのは結果を一般化しますという意味ではないでしょう?正規分布しか扱えない一般線形モデルの拡張という意味で「一般化」と呼ばれているのです。結果を「一般化」することを目的としているのは統計的仮説検定でもモデリングでも一緒でしょう。それぞれにアプローチの仕方が違うだけで,得られた標本から別の集団や標本にも適応される何かを見つけるということですよね(ものすごくおおざっぱにいうと)。

パイロットスタディの結果はパイロットスタディでの標本にいえることのみで議論するのだという立場をとるなら記述統計のみで議論すれば良い話。なんのためにパイロットスタディするのか。なんのためにに統計的仮説検定やモデリングをするのか。というかなんのために研究するのか。そういうことをよくよく考えないといけない,ということを再確認したのでした。

なにをゆう たむらゆう

おしまい

lmer関数とglmer関数(Nagoya.Rの発表の補足)

もう2ヶ月くらい前の話ですが,Nagoya.R #12で発表しました。

今更って感じなのですが,ちょっと今お手伝いでLMEをやっていて,自分でも理解があやふやな点がぼろぼろと出てきたのでメモ的に。

僕は発表中にlmer関数と,モデル比較に使えるstep関数の使い方を説明したのですが,どうやらstep関数はlmer関数で出力したもののみに対応している模様。というか,正規分布を仮定したモデルにしか適用できないみたいです。なので,lmerでfamily指定を使ってポアソン分布(poisson) や二項分布(binomial)を指定した場合には出力がされません。また,lmer関数でfamily指定すると警告メッセージでglmer関数を使うようにと言われます。なので,正規分布以外でやるときはglmer関数を使うほうがいいかもしれません。回帰の式の入力はほぼ一緒です。

ただし,glmer関数は結果の出力の解釈が実はちょっと難しくて,一発だけじゃ全水準の多重比較までみれないんですよね。なので,ダミー変数にいれたものの順番を入れ替えて計算を回していくようなのですが,それに使う引数がstartってやつっぽいのですよね。そんないちいちダミー変数入れ替えるなんてめちゃめんどくさいわけで,これで引数指定して一番最初にいれる水準を指定できるようになっているみたいなのです。ただしちょっと使い方がまだよく理解できていなくてですね…

実際に自分の研究でちゃんと使えるようになるにはここは避けて通れないわけなのですが,そっちばっかりに手を回しているわけにもいかず,RのヘルプやマニュアルとにらめっこしてはGoogle検索して…とかやってたらなんか1日終わっているみたいな幸せなのか不幸せなのかわからない昨日今日です。

いろいろ終わってません

なにをゆう たむらゆう

おしまい。